
Thông lệ của ngành là công bố trước, phát hành sau. Một bài viết trên blog, một bảng giá, đôi khi là một buổi họp báo, rồi mới tới sản phẩm.
Ngày 11/9/2026, Phòng thí nghiệm Trí tuệ nhân tạo Thượng Hải làm ngược lại. Một kho lưu trữ mang tên Atria-Dawn-Preview xuất hiện trên Hugging Face và GitHub, kèm khoảng 1,5 terabyte trọng số mô hình dưới giấy phép MIT, tức cho phép dùng thương mại, sửa đổi và phân phối lại. Không có bài viết giới thiệu, không có thông cáo, không có bảng giá. Bản kiểm điểm FP8 theo sau một ngày. Bài báo kỹ thuật với hơn 140 tác giả chỉ xuất hiện trên arXiv ba ngày sau đó.
Sự kiện diễn ra đúng lúc các phòng lab phương Tây đang tranh luận có nên giảm tốc độ phát triển AI hay không.
Chuyện gì đã xảy ra
Atria Dawn Preview là bản xem trước của một mô hình agentic thế hệ mới do Phòng thí nghiệm Trí tuệ nhân tạo Thượng Hải phát triển. Đây là viện nghiên cứu công lập đứng sau dòng mô hình InternLM.
Điểm cần làm rõ về mặt kỹ thuật: đây không phải một mô hình xây từ đầu. Nó được huấn luyện tiếp trên nền GLM-5.2, mô hình MoE 744 tỷ tham số mà công ty Z.ai phát hành hồi tháng 6/2026, cũng dưới giấy phép MIT. Nói cách khác, cùng một nền tảng, được hai phòng lab huấn luyện theo hai hướng khác nhau rồi đưa ra thị trường như hai sản phẩm riêng.
| Hạng mục | Thông tin |
|---|---|
| Kiến trúc | MoE, tổng 744 tỷ tham số trên nền GLM-5.2 |
| Cửa sổ ngữ cảnh | 256K token (cả bản thường lẫn bản FP8) |
| Đầu vào | Chỉ văn bản, không nhận ảnh hay PDF |
| Giấy phép | MIT, cho phép dùng thương mại |
| Nơi tải | Hugging Face và ModelScope, có bản BF16 và FP8 |
| Triển khai cục bộ | SGLang từ v0.5.13.post1, vLLM từ v0.23.0 |
| Bài báo | arXiv 2609.15818, tiêu đề Atria Dawn: The Dawn of Agentic Superintelligence |
Một lưu ý cho ai đọc tin từ nguồn khác: vài trang đưa cửa sổ ngữ cảnh là 1 triệu token. Con số đó không đúng. Model card chính thức ghi 256K cho cả hai phiên bản, và tệp cấu hình mẫu dành cho Codex cũng đặt giới hạn 256.000.
Điểm cốt lõi: kết quả phải kiểm chứng được, không phải mô hình tự nhận đã xong
Khẩu hiệu của mô hình là "từ câu hỏi nghiên cứu tới kết quả kiểm chứng được". Đây không phải câu quảng cáo suông mà là nguyên tắc thiết kế xuyên suốt.
Mô hình nhắm vào các tình huống nghiên cứu và kỹ thuật đòi hỏi hiểu môi trường liên tục, dùng công cụ, và hoàn thành nhiệm vụ nhiều bước. Nó hỗ trợ trọn vòng lặp gồm phân tích vấn đề, thiết kế giải pháp, dùng công cụ, viết mã, chạy thí nghiệm, phân tích kết quả và khôi phục khi thất bại.
Năng lực được tổ chức theo bốn nhóm:
- Discovery, tức truy xuất và sắp xếp bằng chứng, nghiên cứu sâu, biến câu hỏi nghiên cứu thành kế hoạch thí nghiệm chạy được
- Creation, tức xây phần mềm, ứng dụng tương tác, trò chơi, trực quan hoá dữ liệu và hệ thống học máy
- Delivery, tức biến tài liệu, dữ liệu và yêu cầu thiết kế thành báo cáo, bản trình bày và các sản phẩm có cấu trúc
- Cybersecurity, tức phân tích vấn đề bảo mật, xác minh lỗ hổng, vá lỗi và kiểm thử lại trong môi trường được cấp phép
Điểm khác biệt không nằm ở bốn nhóm này, vì chúng không mới. Nó nằm ở chỗ nhóm phát triển không muốn mô hình chỉ tuyên bố "tôi đã hoàn thành", mà muốn chính môi trường bên ngoài trả lời xem nó có thật sự hoàn thành hay không. Cụ thể: bộ kiểm thử có chạy qua không, tệp có thật sự được tạo ra không, chỉ số thí nghiệm có cải thiện không, trích dẫn có đỡ được kết luận không, và lỗ hổng sau khi vá có còn khai thác được nữa không.
Đây là điều đáng học nhất từ bản phát hành này, và nó nối thẳng với phát hiện của benchmark Real-SWE mà AI Hub đã đăng: khi ba kiểu lỗi hàng đầu của AI đều là bỏ sót yêu cầu và hành động trên giả định chưa kiểm chứng, thì cơ chế buộc kiểm chứng từ bên ngoài chính là hướng xử lý đúng.
Kết quả & bối cảnh
Model card công bố kết quả trên 16 benchmark, đối chiếu với DeepSeek V4 Pro, Kimi K3, Qwen 3.8 Max, GLM 5.3, GPT-5.6 Sol và Claude Opus 5. Bài báo mô tả mô hình là cạnh tranh được với các agent tiên phong và đạt điểm cao nhất ở năm hạng mục.
Nhưng bức tranh đầy đủ thì phân hoá rất rõ.
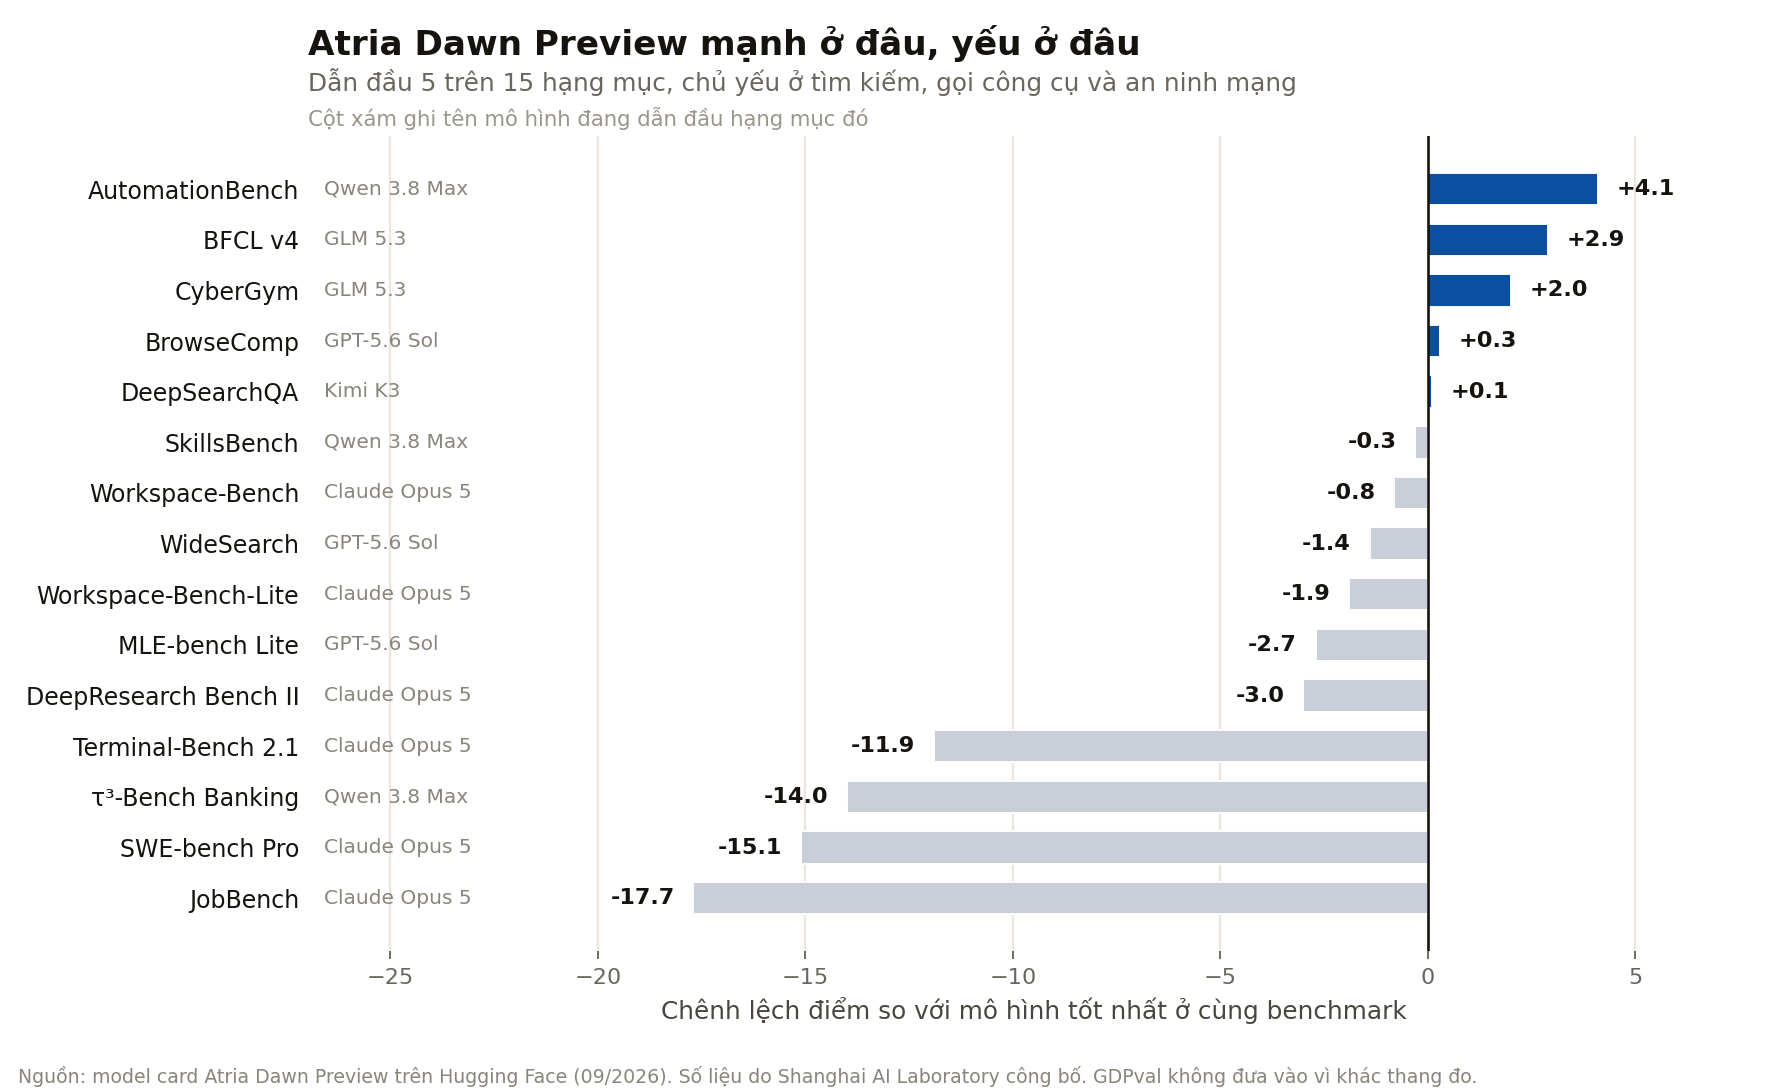
Nơi mô hình dẫn đầu đều thuộc ba nhóm: tìm kiếm, gọi công cụ và an ninh mạng. Cụ thể là AutomationBench với 53,8 điểm, BFCL v4 với 77,0, CyberGym với 86,5, BrowseComp với 92,5 và DeepSearchQA với 96,0. Riêng hai hạng mục cuối, khoảng cách với đối thủ chỉ 0,1 và 0,3 điểm, tức là ngang nhau trên thực tế chứ không phải vượt trội.
Nơi mô hình thua đậm lại là các hạng mục kỹ thuật phần mềm cốt lõi và công việc văn phòng. Trên SWE-bench Pro, mô hình đạt 59,6 so với 74,7 của Claude Opus 5. Trên Terminal-Bench 2.1, đạt 78,3 so với 90,2. Trên JobBench, đạt 50,3 so với 68,0. Claude Opus 5 dẫn đầu bảy trên mười lăm hạng mục.
Một điểm đáng chú ý riêng với ngành tài chính. Trên τ³-Bench Banking, bộ đánh giá năng lực xử lý nghiệp vụ ngân hàng, Atria Dawn đạt 41,2 điểm, thấp hơn Qwen 3.8 Max ở mức 55,2 tới 14 điểm. Đây là hạng mục mô hình yếu thứ hai trong toàn bảng. Với một đơn vị trong ngành thanh toán, đây là con số cần biết trước khi cân nhắc thử nghiệm.
Nghiên cứu về cách người và AI làm việc cùng nhau
Phần này trong bài báo đáng chú ý hơn cả bảng điểm, và chính nhóm tác giả cũng nhấn mạnh như vậy.
Họ phân tích 769 bản ghi tác vụ từ 56 người dùng mô hình trong quá trình phát triển. Người tham gia đánh giá khoảng một phần ba số tác vụ đã hoàn thành là bất khả thi nếu không có AI.
Mô hình làm việc mà họ quan sát được: agent thường đề xuất phương pháp và thực hiện các chỉnh sửa, trong khi con người giữ phần lớn quyết định cuối cùng và định hướng quá trình khám phá bằng phán đoán cùng phản hồi. Nhóm tác giả gọi đây là bước chuyển từ thực thi ở mức tác vụ sang cộng tác ở mức dự án.
Cần đọc con số một phần ba đúng cách, và bài báo cũng nói rõ: đây là đánh giá chủ quan của người tham gia, không phải bằng chứng về tính tự chủ độc lập của mô hình.
Cần thận trọng khi đọc kết quả này
Toàn bộ điểm số do chính phòng lab công bố và chưa có bên thứ ba nào kiểm chứng độc lập. Với mọi công bố mô hình mới, cách đọc an toàn là xem đây là chỉ dấu về hướng cải thiện, không phải kết luận đã được xác thực.
Tiêu đề bài báo là một tuyên bố rất mạnh. Bài mang tên "Bình minh của siêu trí tuệ tác nhân". Nội dung bên trong mô tả một mô hình cạnh tranh được ở một số hạng mục và thua đáng kể ở nhiều hạng mục khác. Khoảng cách giữa tiêu đề và số liệu là điều nên ghi nhận.
Đây là bản xem trước, không phải bản chính thức. Nhóm phát triển tự đặt tên là Preview, và tới thời điểm phát hành trọng số vẫn chưa có tài liệu chính thức nào ngoài model card.
Mô hình chỉ nhận văn bản. Nó từ chối ảnh và PDF, trả về lỗi khi nhận đầu vào đa phương thức. Muốn dùng với Codex hay Claude Code phải cấu hình thêm để chặn đầu vào ảnh ngay từ phía máy khách, và model card có hướng dẫn riêng cho việc này.
Tự triển khai đòi hạ tầng nặng. Trọng số khoảng 1,5 terabyte, cần cụm nhiều GPU. Bản FP8 giúp giảm nhu cầu bộ nhớ nhưng vẫn ngoài tầm với của máy cá nhân. Thực tế đây là lựa chọn dành cho tổ chức có sẵn hạ tầng tính toán, không phải cho cá nhân.
Ý nghĩa với chúng ta
Đây là tin về một mô hình mà phần lớn nhân sự sẽ không dùng trực tiếp. Nhưng có ba điều rút ra được.
Thứ nhất, cách phát hành này là một chỉ dấu đáng theo dõi. Trong khi các phòng lab phương Tây khoá dần những năng lực nhạy cảm sau các chương trình xét duyệt, như Daybreak của OpenAI, Fairwind của Google và Glasswing của Anthropic mà AI Hub đã đăng, thì ở đây một phòng lab công lập thả toàn bộ trọng số của một mô hình agentic dưới giấy phép cho phép dùng thương mại, không cần đàm phán. Hai hướng đi ngược nhau hoàn toàn. Đáng chú ý là mô hình này cũng dẫn đầu ở hạng mục an ninh mạng CyberGym, tức là chính loại năng lực mà phía bên kia đang siết.
Thứ hai, nguyên tắc thiết kế thì dùng được ngay, bất kể có dùng mô hình này hay không. Ý tưởng cốt lõi rất đơn giản: đừng để AI tự tuyên bố đã hoàn thành, hãy để môi trường bên ngoài xác nhận. Áp vào công việc của phòng, điều này nghĩa là khi giao việc cho AI, nên yêu cầu bằng chứng kiểm chứng được như đường dẫn nguồn, kết quả chạy thật, hoặc đối chiếu với tài liệu gốc, thay vì chấp nhận một bản tóm tắt nghe hợp lý.
Thứ ba, đừng chọn mô hình theo con số tổng quát. Bảng điểm cho thấy cùng một mô hình có thể dẫn đầu ở tìm kiếm mà thua 14 điểm ở nghiệp vụ ngân hàng. Với loại việc cụ thể của mình, cách đáng tin nhất vẫn là tự đo trên khối lượng công việc thật, như bài về Real-SWE đã nêu.
Lưu ý an toàn dữ liệu: với mô hình do phòng thí nghiệm nước ngoài phát triển, dù trọng số mở, mọi thử nghiệm liên quan tới dữ liệu nội bộ VNPAY đều cần xác nhận trước với bộ phận công nghệ thông tin và an toàn thông tin. Nguyên tắc chung không đổi: không đưa mã nguồn nội bộ, cấu hình hệ thống hay dữ liệu khách hàng vào công cụ AI chưa được duyệt.
Trong một tuần mà giới lãnh đạo AI phương Tây tranh luận về việc có nên đi chậm lại, một phòng thí nghiệm ở Thượng Hải trả lời câu hỏi đó theo cách của riêng mình: không tranh luận, chỉ lặng lẽ đăng trọng số lên mạng.
References
- Shanghai Artificial Intelligence Laboratory — Atria Dawn Preview (model card, 11/09/2026). Available at: https://huggingface.co/internlm/Atria-Dawn-Preview (Accessed: 16/09/2026).
- Guo, H. và cộng sự — Atria Dawn: The Dawn of Agentic Superintelligence, arXiv:2609.15818 (2026). Available at: https://arxiv.org/abs/2609.15818 (Accessed: 16/09/2026).
- GitHub — atria-asi/Atria-Dawn-Preview. Available at: https://github.com/atria-asi/Atria-Dawn-Preview (Accessed: 16/09/2026).
- AI Weekly — Shanghai AI Lab Ships Atria Dawn Preview, a 744B Agentic MoE Built on GLM-5.2 (15/09/2026). Available at: https://aiweekly.co/alerts/shanghai-ai-lab-ships-atria-dawn-preview-a-744b-agentic-moe (Accessed: 16/09/2026).
- Startup Fortune — Shanghai AI Lab Quietly Releases Atria, a Free 744 Billion Parameter AI Agent (09/2026). Available at: https://startupfortune.com/shanghai-ai-lab-quietly-releases-atria-a-free-744-billion-parameter-ai-agent/ (Accessed: 16/09/2026).
- OrcaRouter — Atria Dawn Preview: InternLM's 744B Agentic MoE Ships Quietly (14/09/2026). Available at: https://www.orcarouter.ai/blog/atria-dawn-preview-quiet-release (Accessed: 16/09/2026).
- AI/TLDR — Atria Dawn Preview — the report behind Shanghai AI Laboratory's quiet release. Available at: https://ai-tldr.dev/releases/shanghai-ai-lab-atria-dawn-report/ (Accessed: 16/09/2026).