
Có hai cách để một mô hình AI rẻ hơn. Cách quen thuộc là thu nhỏ nó lại và chấp nhận kết quả kém hơn. Cách thứ hai khó hơn nhiều: giữ nguyên năng lực, nhưng thiết kế lại phần tốn kém nhất trong quá trình vận hành.
Ngày 10/9/2026, DeepSeek công bố V4.1 Flash theo cách thứ hai. Mô hình có 552 tỷ tham số, trọng số mở dưới giấy phép MIT, nhưng điểm đáng nói không nằm ở con số đó. Nó nằm ở chỗ bộ nhớ đệm mà mô hình phải giữ trong lúc làm việc đã giảm xuống còn khoảng một phần tư so với thế hệ trước, và đó chính là khoản chiếm phần lớn hóa đơn khi vận hành một AI agent.
Giá đầu vào giảm 33% theo sau. Đây là quan hệ nhân quả trực tiếp, không phải chiến lược giá.
Chuyện gì đã xảy ra
DeepSeek công bố V4.1 Flash lúc 06:10 giờ quốc tế ngày 10/9/2026, tức 14:10 giờ Bắc Kinh. Trọng số lên Hugging Face dưới giấy phép MIT, cho phép dùng thương mại, sửa đổi và phân phối lại. Tính tới giữa tháng 9, mô hình đã có hơn 325 nghìn lượt tải.
| Hạng mục | Thông tin |
|---|---|
| Kiến trúc | MoE đa phương thức, 552 tỷ tham số nền |
| Tham số kích hoạt | 8 tỷ khi đọc đầu vào, 16 tỷ khi sinh đầu ra |
| Cửa sổ ngữ cảnh | 1 triệu token |
| Đầu vào | Văn bản và hình ảnh |
| Dữ liệu huấn luyện | 45 nghìn tỷ token, huấn luyện từ đầu |
| Giấy phép | MIT |
| Mức suy luận | Điều chỉnh liên tục theo thang số nguyên từ 1 đến 100 |
Tên đầy đủ của báo cáo kỹ thuật cho thấy rõ trọng tâm: Đẩy giới hạn của việc nén bộ đệm KV. DeepSeek gọi đây là mô hình nhỏ nhất trong một dòng kiến trúc mới, tức ngầm báo sẽ có bản Pro theo sau.
Điểm cốt lõi: một kiến trúc cũ quay lại theo cách mới
Để hiểu vì sao điều này đáng chú ý, cần biết chỗ tốn kém nằm ở đâu.
Khi một mô hình ngôn ngữ xử lý văn bản, nó phải lưu lại trạng thái trung gian của từng token đã đọc để dùng cho các bước sau. Phần lưu trữ này gọi là bộ đệm KV. Trong thiết kế thông thường, mỗi lớp của mô hình tự tính và tự lưu bộ đệm của riêng nó, nên dung lượng tăng tuyến tính theo cả độ dài văn bản lẫn số lớp. Với một agent đọc hàng trăm nghìn token rồi làm việc liên tục qua nhiều lượt, đây chính là khoản đắt nhất.
Kiến trúc Causal Encoder-Decoder. V4.1 Flash chia 40 lớp Transformer thành hai nửa: một encoder nhân quả 20 lớp, theo sau là decoder 20 lớp. Thay vì mỗi lớp decoder tự dẫn xuất bộ đệm KV từ trạng thái ẩn của chính nó, bộ đệm KV toàn cục được chiếu một lần duy nhất từ trạng thái ẩn cuối cùng của encoder.
Hệ quả là mô hình chỉ cần kích hoạt 8 tỷ tham số cho mỗi token khi đọc đầu vào, và 16 tỷ khi sinh đầu ra, trên tổng số 552 tỷ. Nói cách khác, DeepSeek thiết kế để mô hình tốn ít sức khi nạp thông tin, dành sức cho lúc thật sự cần suy luận và trả lời. Đây là sự phân bổ hợp lý với công việc agent, vốn đọc rất nhiều nhưng viết ra tương đối ít.
Điều thú vị về mặt lịch sử: kiến trúc encoder-decoder từng là chuẩn mực trong giai đoạn đầu của Transformer, rồi bị thay thế gần như hoàn toàn bởi thiết kế chỉ có decoder. Việc nó quay lại ở một mô hình tiên phong là chi tiết khiến giới kỹ thuật chú ý nhất.
Bốn con số về bộ nhớ, đừng gộp làm một:
- Bộ đệm KV toàn cục còn khoảng 890 byte mỗi token
- Con số đó bằng khoảng một phần tư so với DeepSeek V4-Flash
- Dung lượng lưu trữ bền vững còn khoảng một phần tám, nhờ cơ chế tái dựng trạng thái bằng cách phát lại một số token gần nhất thay vì ghi xuống ổ đĩa
- So với DeepSeek V1, mức giảm là khoảng 437 lần
Các kỹ thuật đứng sau gồm một cơ chế chú ý thưa nén phân ba chế độ cho từng lớp, một bộ lập chỉ mục phân cấp giới hạn chi phí ở các lớp sâu bất kể độ dài ngữ cảnh, và việc lưu bộ đệm chính ở định dạng FP4. Mô hình còn có một khối bộ nhớ có điều kiện 196 tỷ tham số được truy cập thưa theo token, và cơ chế giải mã suy đoán riêng.
Giá bán phản ánh trực tiếp thay đổi kỹ thuật. Mức ngoài giờ cao điểm là 0,003 USD cho mỗi triệu token đầu vào đã lưu đệm, 0,15 USD cho đầu vào chưa lưu đệm và 0,60 USD cho đầu ra. Giờ cao điểm gấp đôi. So với giá cũ của V4-Flash, ba mức này lần lượt rẻ hơn 60, 33 và 11 phần trăm. DeepSeek nói thẳng rằng bộ đệm nhỏ hơn chính là thứ cho phép họ hạ giá.
Kết quả & bối cảnh
Trên các bộ đánh giá thiên về công việc agent, mô hình đạt kết quả tốt và ở một số hạng mục vượt cả các mô hình đắt hơn nhiều lần. Theo số liệu DeepSeek công bố ở chế độ suy luận tối đa:
| Bộ đánh giá | V4.1 Flash | Mô hình tốt nhất còn lại |
|---|---|---|
| DeepSWE v1.1 | 74,2 | Claude Opus 5: 74,0 |
| CyberGym | 88,1 | GPT-5.6 Sol và GLM-5.3: 84,5 |
| AutomationBench | 54,8 | Claude Opus 5: 50,3 |
| Agent's Last Exam | 31,8 | Claude Opus 5: 28,6 |
| HLE có công cụ | 63,9 | Claude Opus 5: 63,6 |
| Codeforces (điểm xếp hạng) | 3471 | DeepSeek V4-Pro: 3348 |
Điểm đáng chú ý về mặt kinh tế: V4-Pro, mô hình lớn hơn với 1,6 nghìn tỷ tham số nền và 49 tỷ tham số kích hoạt, bị chính V4.1 Flash vượt qua ở nhiều hạng mục dù mô hình mới kích hoạt ít tham số hơn ba tới sáu lần.
Về vòng đời sản phẩm, V4-Flash và bản thị giác thử nghiệm đã ngừng hỗ trợ, các mã model cũ tạm thời được định tuyến sang V4.1 Flash. Từ 04:00 giờ quốc tế ngày 14/9, mọi yêu cầu gửi tới V4-Pro cũng được chuyển sang V4.1 Flash với mức giá của mô hình mới. Tuy nhiên tài liệu API sau đó ghi rằng dịch vụ V4-Pro vẫn tiếp tục theo yêu cầu từ người dùng, mức tính phí không đổi.
Cần thận trọng: bốn điểm dễ bị bỏ qua
Bảng điểm phân hoá rất mạnh theo độ khó của bài kiểm tra. Đây là điểm quan trọng nhất trong bài.
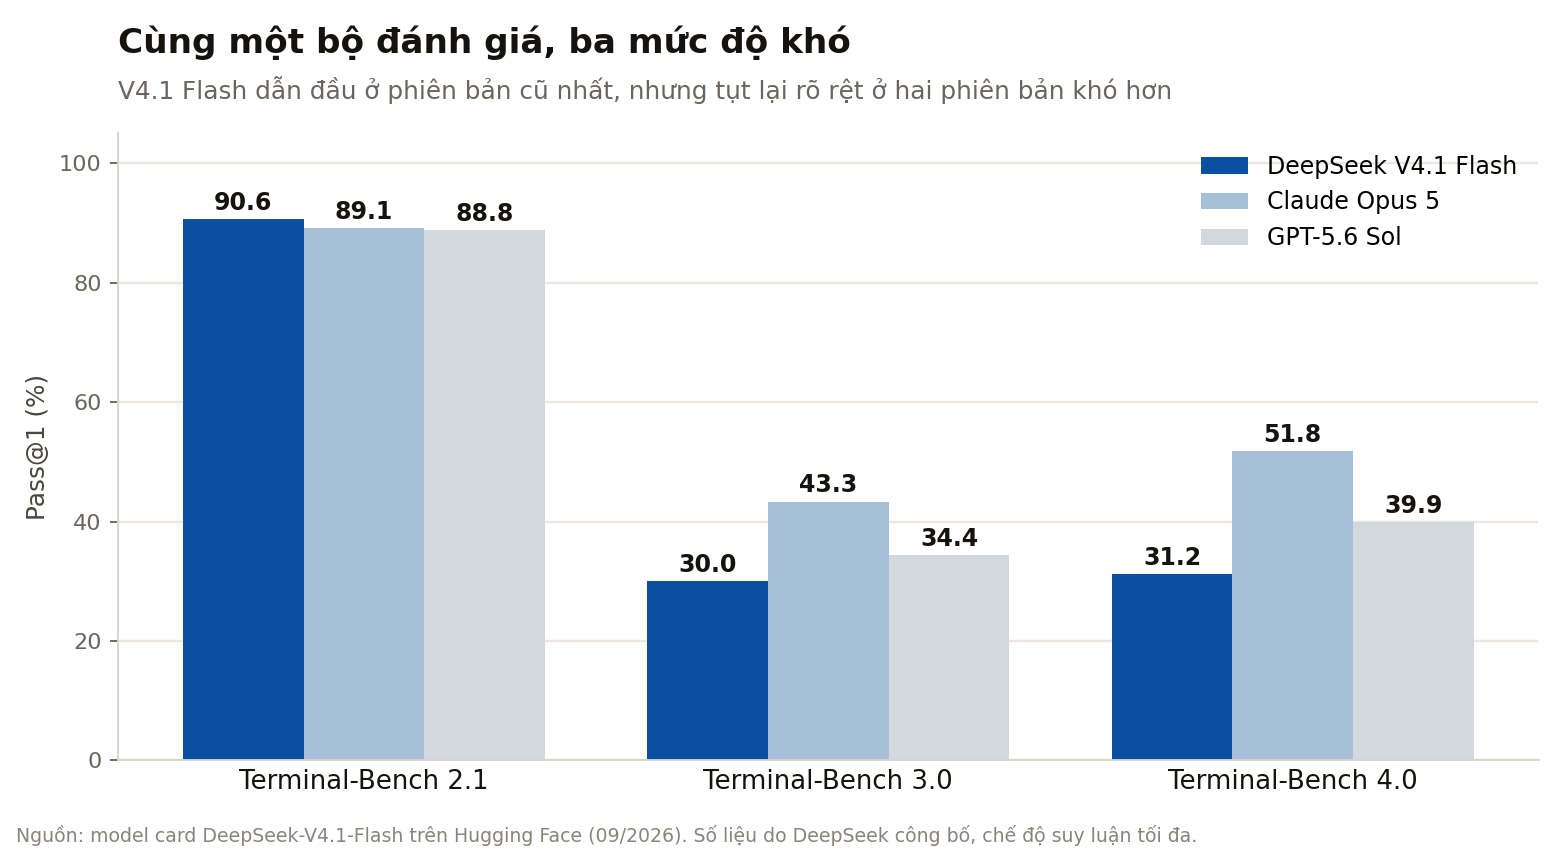
Trên Terminal-Bench 2.1, mô hình đạt 90,6 điểm và dẫn đầu, vượt Claude Opus 5 ở mức 89,1. Nhưng trên hai phiên bản khó hơn của cùng bộ đánh giá đó, khoảng cách đảo chiều hoàn toàn: ở bản 3.0, mô hình đạt 30,0 so với 43,3 của Opus 5; ở bản 4.0, đạt 31,2 so với 51,8.
Cách đọc đúng: mô hình rất mạnh ở những nhiệm vụ nằm trong vùng nó được tối ưu, nhưng khoảng cách với các mô hình tiên phong phương Tây vẫn còn rõ ở những nhiệm vụ khó hơn. Một bài viết chỉ lấy con số 90,6 rồi bỏ qua hai con số kia là bài viết không trung thực.
Mẫu hình tương tự xuất hiện ở nơi khác. Trên bộ đánh giá HLE khi không dùng công cụ, mô hình đạt 36,8 điểm so với 56,3 của Opus 5, một khoảng cách rất lớn. Nhưng khi được dùng công cụ, nó lại đạt 63,9 và dẫn đầu. Điều này gợi ý rằng thế mạnh của mô hình nằm ở việc điều phối công cụ nhiều hơn là ở tri thức thuần túy.
Toàn bộ số liệu do chính DeepSeek công bố. Chưa có bên thứ ba độc lập tái lập lại. Với mọi công bố mô hình mới, cách đọc an toàn là xem đây là chỉ dấu về hướng cải thiện, không phải kết luận đã được kiểm chứng.
Khung chạy ảnh hưởng tới kết quả gần bằng chính mô hình.
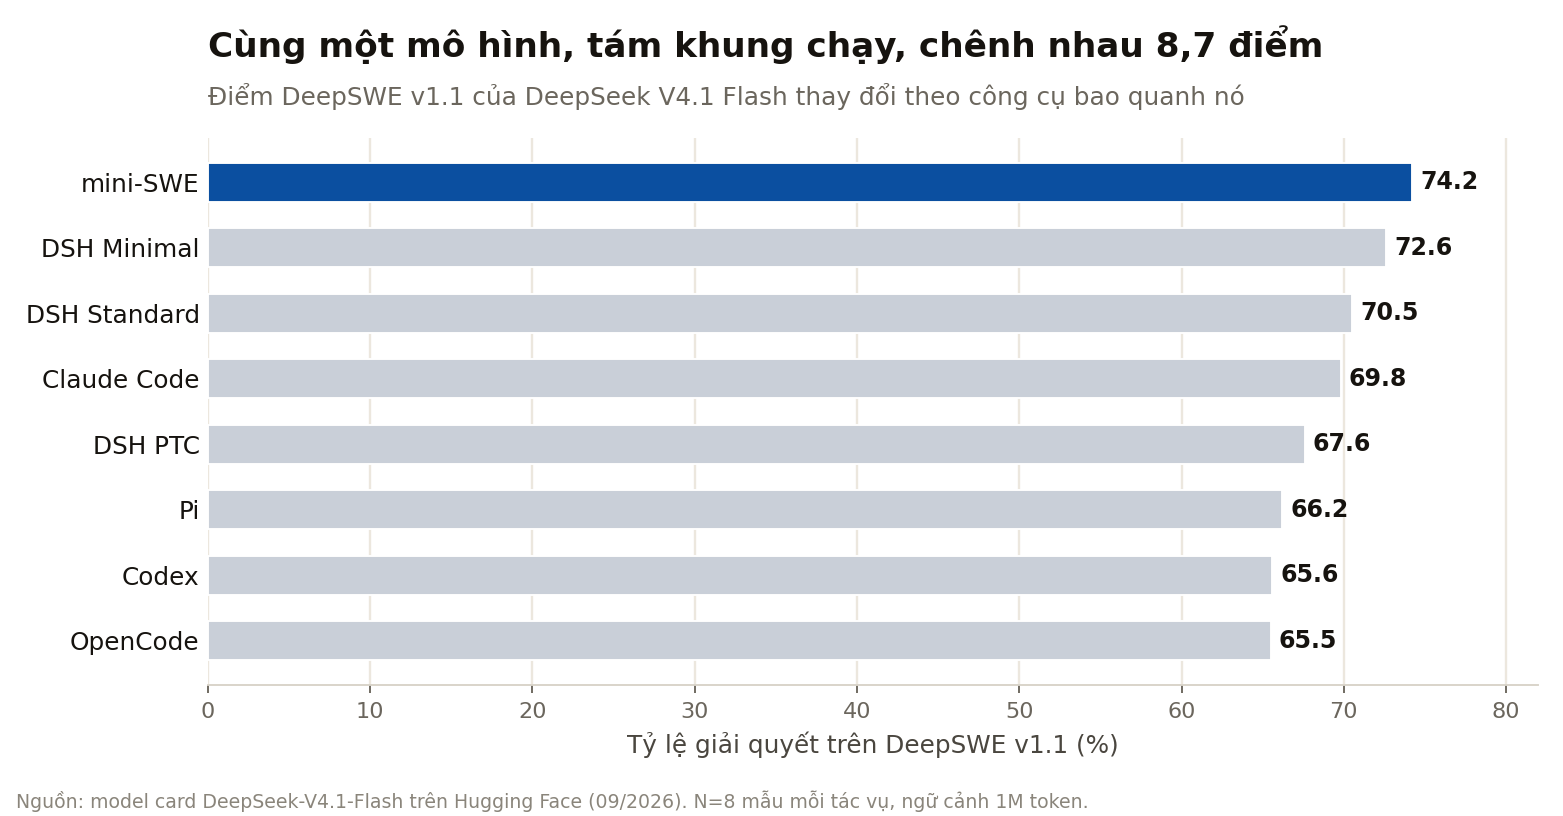
Model card công bố kết quả của cùng một mô hình trên tám khung chạy khác nhau, và điểm số trải từ 65,5 tới 74,2, tức chênh 8,7 điểm. Con số 74,2 mà DeepSeek đưa vào bảng so sánh chính là kết quả ở khung tốt nhất.
Đây không phải điều gì mờ ám, vì họ công bố công khai cả tám con số. Nhưng nó là lời nhắc quan trọng khi so sánh mô hình: một điểm số luôn là điểm của cặp mô hình cộng công cụ, không phải của riêng mô hình. Cùng một mô hình đặt vào công cụ khác có thể tụt gần chín điểm.
Chạy cục bộ vẫn không khả thi với phần lớn tổ chức. Dù chỉ kích hoạt 8 tỷ tham số mỗi token, toàn bộ 552 tỷ tham số vẫn phải nằm sẵn trong bộ nhớ. Thảo luận trong cộng đồng kỹ thuật chỉ ra rằng ngay cả các cấu hình máy trạm cao cấp cũng không đủ, nên với công việc agent chạy tại chỗ thì các mô hình nhỏ hơn vẫn thực tế hơn. Ngoài ra bản phát hành không kèm mẫu hội thoại theo định dạng phổ biến, mà đi kèm một bộ công cụ riêng viết bằng Rust, tức là tích hợp cần thêm công sức.
Ý nghĩa với chúng ta
Đây là tin về một mô hình mà phần lớn nhân sự sẽ không dùng trực tiếp. Nhưng có ba điều rút ra được, áp dụng cho bất kỳ ai đang cân nhắc đưa AI agent vào quy trình.
Thứ nhất, chi phí agent nằm ở chỗ đọc, không phải chỗ viết. Bài học lớn nhất từ bản phát hành này là DeepSeek xác định đúng chỗ tốn kém rồi thiết kế lại đúng chỗ đó. Với đội ngũ đang dự toán chi phí AI, điều này có nghĩa là khi so sánh nhà cung cấp, nên nhìn kỹ giá đầu vào đã lưu đệm và chính sách lưu đệm, chứ không chỉ nhìn giá đầu ra. Với một agent đọc tài liệu dài và làm việc qua nhiều lượt, khoản đó mới là phần lớn hóa đơn.
Thứ hai, đừng so sánh mô hình bằng một con số duy nhất. Bảng điểm ở trên cho thấy cùng một mô hình có thể dẫn đầu ở một phiên bản của bộ đánh giá rồi tụt hai mươi điểm ở phiên bản khó hơn, và cùng một mô hình có thể chênh gần chín điểm chỉ vì đổi công cụ bao quanh. Điều này củng cố kết luận từ bài về benchmark Real-SWE mà AI Hub đã đăng: cách đáng tin nhất vẫn là tự đo trên khối lượng công việc thật của mình.
Thứ ba, khoảng cách giá giữa mô hình mở và mô hình đóng đang rất lớn. Giá đầu vào chưa lưu đệm của mô hình này là 0,15 USD cho mỗi triệu token, trong khi các mô hình tiên phong phương Tây phát hành trong tháng 9 nằm ở mức 10 USD cho cùng đơn vị. Chênh lệch hàng chục lần. Với những công việc không đòi hỏi năng lực ở mức cao nhất, đây là dữ kiện đáng đưa vào bài toán lựa chọn, kèm điều kiện về bảo mật dữ liệu ở đoạn dưới.
Lưu ý an toàn dữ liệu: với mô hình do đơn vị nước ngoài phát triển, dù trọng số mở, mọi thử nghiệm liên quan tới dữ liệu nội bộ VNPAY đều cần xác nhận trước với bộ phận công nghệ thông tin và an toàn thông tin. Đặc biệt lưu ý phân biệt hai hình thức: gọi qua API của nhà cung cấp là gửi dữ liệu ra ngoài, còn tự triển khai trên hạ tầng của mình thì không, và hai hình thức này có mức rủi ro hoàn toàn khác nhau. Nguyên tắc chung không đổi: không đưa mã nguồn nội bộ, cấu hình hệ thống hay dữ liệu khách hàng vào công cụ AI chưa được duyệt.
Trong một năm mà phần lớn thông cáo về mô hình mới đều xoay quanh việc điểm số cao hơn bao nhiêu, bản phát hành này nhắc lại một điều mà ngành kỹ thuật vốn đã biết: tiến bộ đáng kể nhất thường đến từ việc nhìn ra đâu là chỗ đắt nhất, rồi thiết kế lại đúng chỗ đó.
References
- DeepSeek — Introducing DeepSeek-V4.1-Flash: smarter, faster, more efficient (10/09/2026). Available at: https://deepseek.com/en/news/deepseek-v4-1-flash/ (Accessed: 16/09/2026).
- DeepSeek AI — DeepSeek-V4.1-Flash (model card và báo cáo kỹ thuật). Available at: https://huggingface.co/deepseek-ai/DeepSeek-V4.1-Flash (Accessed: 16/09/2026).
- DeepSeek API Docs — DeepSeek-V4.1-Flash: Smarter, Faster, More Efficient (10/09/2026). Available at: https://api-docs.deepseek.com/news/news260910/ (Accessed: 16/09/2026).
- KDnuggets — Why DeepSeek-V4.1-Flash Is Such an Exciting Open Model Release (14/09/2026). Available at: https://www.kdnuggets.com/why-deepseek-v4-1-flash-is-such-an-exciting-open-model-release (Accessed: 16/09/2026).
- MindStudio — DeepSeek V4.1 Flash Specs: KV Cache Compression Explained (10/09/2026). Available at: https://www.mindstudio.ai/blog/deepseek-v4-1-flash-specs-architecture (Accessed: 16/09/2026).
- CellCog — DeepSeek V4.1 Flash: Price, Specs, and the Rumor Scorecard. Available at: https://cellcog.ai/blog/deepseek-v4-1-flash-release-date/ (Accessed: 16/09/2026).
- Latent Space — DeepSeek v4.1-Flash: novel causal Encoder–Decoder architecture with vision (thảo luận cộng đồng kỹ thuật). Available at: https://www.latent.space/p/ainews-deepseek-v41-flash-763b-p8b (Accessed: 16/09/2026).