
Ngày 21/9/2026, SpaceXAI, tên gọi mới của công ty xAI, phát hành Grok 4.7 [1][4]. Đây là bản nâng cấp giữ nguyên mức giá của Grok 4.6, với thông điệp chính là cải thiện năng lực xử lý các tác vụ chạy dài nhiều giờ [2].
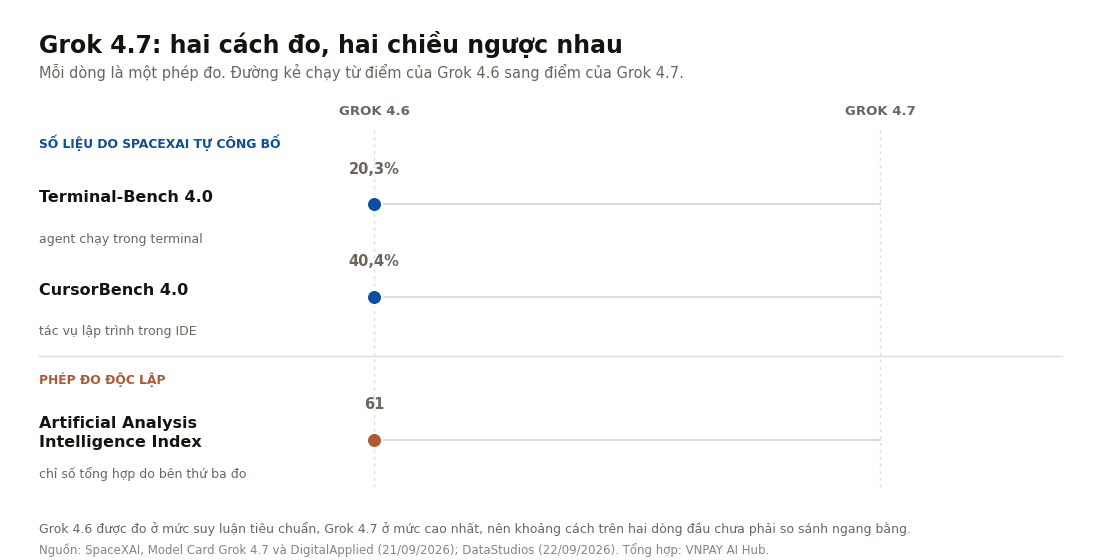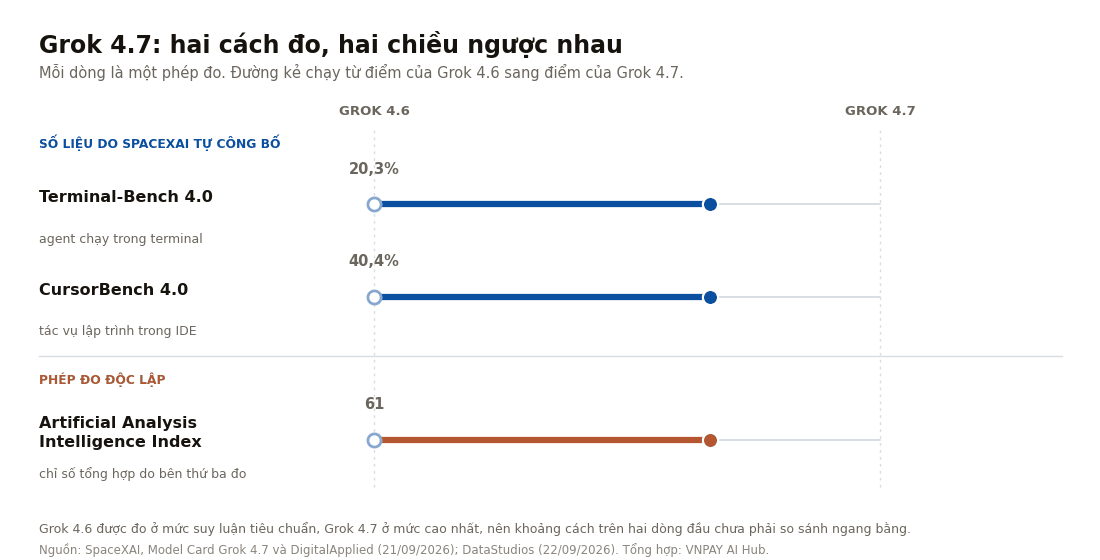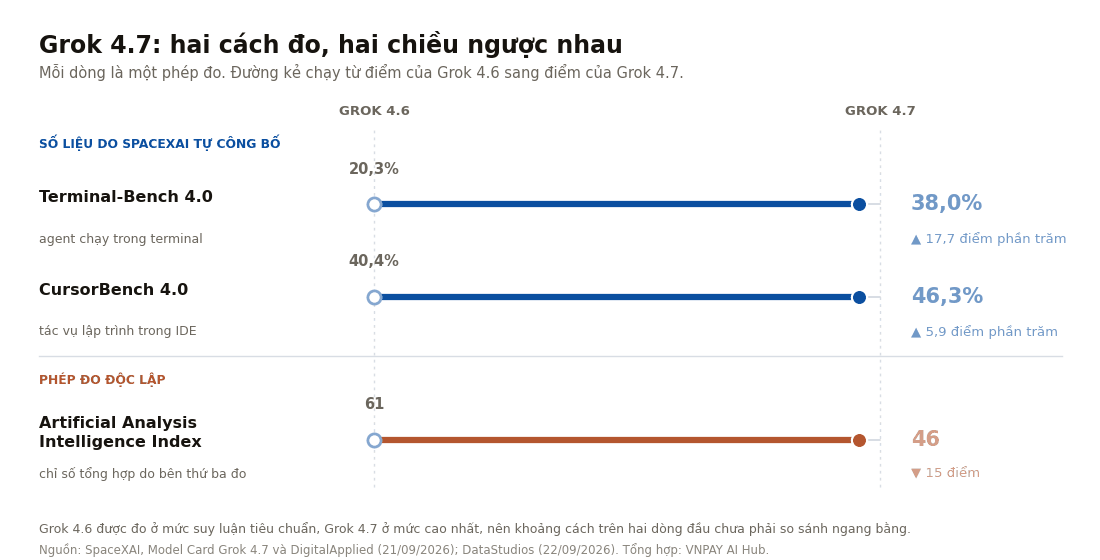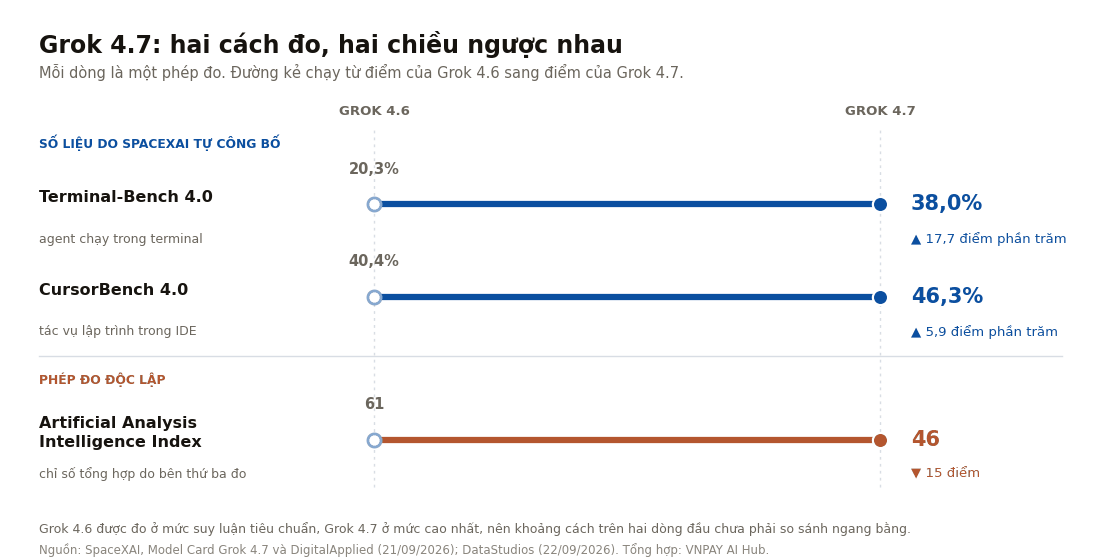
Điểm khiến bản phát hành này đáng chú ý không nằm ở bảng điểm. Toàn bộ bảy phép đo do SpaceXAI công bố đều tăng so với Grok 4.6 [6]. Nhưng khi một đơn vị đo độc lập chạy lại theo phương pháp riêng của họ, kết quả đi ngược chiều [7]. Đây là một trường hợp minh hoạ rõ vì sao không nên chọn mô hình chỉ dựa vào thông cáo phát hành.
Thay đổi kỹ thuật: mô hình nền lớn hơn và vòng huấn luyện tăng cường dài hơn
Theo model card chính thức và bản tổng hợp của LLM Stats, Grok 4.7 dùng một mô hình nền mới lớn hơn Grok 4.6, sau đó chạy một vòng học tăng cường dài hơn trên tập bài toán khó, nghiêng về những việc cần nhiều giờ để hoàn thành [1][2]. Hai điểm được nhấn mạnh là khả năng tự kiểm chứng kết quả và hỗ trợ sẵn cho Grok Bot [2].
| Hạng mục | Grok 4.7 |
|---|---|
| Ngữ cảnh | 500.000 token [4][6] |
| Đầu vào | Văn bản và hình ảnh; đầu ra chỉ có văn bản [1][4] |
| Mốc kiến thức | Tháng 6/2026 cho giai đoạn pretraining, dữ liệu bổ sung tới tháng 8/2026 [1] |
| Mức suy luận | Bốn mức: low, medium, high, xhigh [4] |
| Tính năng API | Gọi hàm, tìm kiếm web, tìm kiếm trên X, thực thi mã [4] |
Model card cũng nêu rõ phạm vi sử dụng phù hợp gồm công việc kỹ thuật và sáng tạo, nghiên cứu khoa học, gia cố hạ tầng trọng yếu và nghiên cứu AI. Đồng thời, model card ghi rõ mô hình không phù hợp cho các quyết định quan trọng theo hướng tự động hoàn toàn trong y tế, pháp lý, tài chính hoặc các hệ thống an toàn trọng yếu nếu không có con người giám sát [1].
Giá giữ nguyên, nhưng có hai tầng cần lưu ý
Mức giá không đổi so với Grok 4.6, song cấu trúc giá chia theo độ dài ngữ cảnh [2][6]:
| Hạng mục | Dưới 200.000 token | Từ 200.000 token trở lên |
|---|---|---|
| Token đầu vào | 2 USD / triệu | 4 USD / triệu |
| Token đầu vào đã cache | 0,50 USD / triệu | 1 USD / triệu |
| Token đầu ra | 6 USD / triệu | 12 USD / triệu |
Điểm dễ bỏ sót: khi vượt ngưỡng 200.000 token, toàn bộ yêu cầu được tính ở mức giá cao hơn, không phải chỉ phần vượt ngưỡng [2].
Ngoài ra, bản chạy nhanh (Fast) có giá gấp đôi mức tiêu chuẩn và chỉ dùng được qua Cursor và Grok Build, không có trên API công khai [6]. MarkTechPost cho biết endpoint đặt tại Mỹ có phụ phí 10% [4]. DigitalApplied ghi nhận ngày 22/9, OpenRouter bán thấp hơn giá niêm yết khoảng 20%, tức 1,60 USD và 4,80 USD [6]. Nói cách khác, giá thực tế phụ thuộc vào đường dẫn truy cập.
Điểm benchmark do nhà cung cấp công bố
Bảng dưới đây là so sánh giữa ba mô hình, theo tổng hợp của OfficeChai [5]:
| Benchmark | Grok 4.7 | GPT-5.6 Sol | Claude Fable 5.1 |
|---|---|---|---|
| EEBench | 64,0% | 39,4% | 56,4% |
| Harvey Legal | 19,6% | 2,5% | 6,7% |
| DeepSWE v1.1 | 71,0% | 72,7% | 70,0% |
| CursorBench 4.0 | 46,3% | 41,7% | 51,8% |
| Terminal-Bench 4.0 | 38,0% | 37,3% | 57,9% |
| HealthBench Professional | 56,7% | 60,5% | 62,1% |
Trên GDPval, Grok 4.7 đạt 1.695 điểm Elo, thấp hơn Claude Fable 5.1 (1.735) nhưng cao hơn GPT-6 Astra (1.542) theo cùng bản tổng hợp này [5].
Lưu ý về số liệu: model card ghi EEBench đạt 66,0% ở mức xhigh, trong khi bảng so sánh trên dùng 64,0% [1][5]. Chênh lệch này nhiều khả năng đến từ mức suy luận được chọn khi chạy, đây cũng là lý do các con số từ những nguồn khác nhau không phải lúc nào cũng khớp.
So với chính Grok 4.6, mức cải thiện rõ nhất nằm ở Terminal-Bench 4.0, từ 20,3% lên 38,0%, và CursorBench 4.0, từ 40,4% lên 46,3% [6].
Phép đo độc lập cho kết quả ngược lại
Đây là phần quan trọng nhất của bài.
Theo DataStudios, tổ chức đo lường Artificial Analysis chấm Grok 4.7 đạt 46 điểm trên Intelligence Index, xếp hạng 16 trong số 655 mô hình. Cùng phương pháp đó, Grok 4.6 đạt 61 điểm. Tức là bản mới thấp hơn bản cũ 15 điểm trên thang đo độc lập, trong khi nhà cung cấp báo cáo cải thiện trên mọi phép đo của mình [7].
Cùng báo cáo này nêu thêm hai điểm đáng lưu ý [7]:
- Lượng token tiêu thụ tăng hơn gấp đôi. Trong thử nghiệm, Grok 4.7 dùng khoảng 81.000 token đầu ra cho mỗi tác vụ, so với 36.000 token của Grok 4.6, tức gấp khoảng 2,25 lần. Giá token không đổi, nhưng chi phí thực tế cho mỗi công việc hoàn thành thì tăng.
- Mức suy luận khi so sánh không đồng nhất. Grok 4.7 được báo cáo ở mức suy luận cao nhất, còn Grok 4.6 ở mức tiêu chuẩn. So sánh hai con số chạy ở hai mức khác nhau sẽ không phản ánh đúng khoảng cách năng lực.
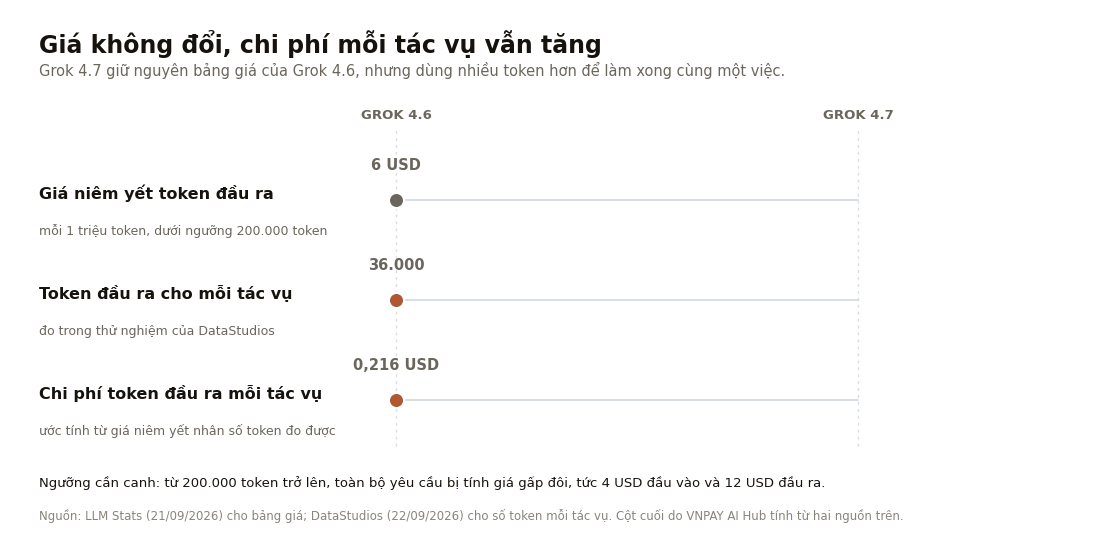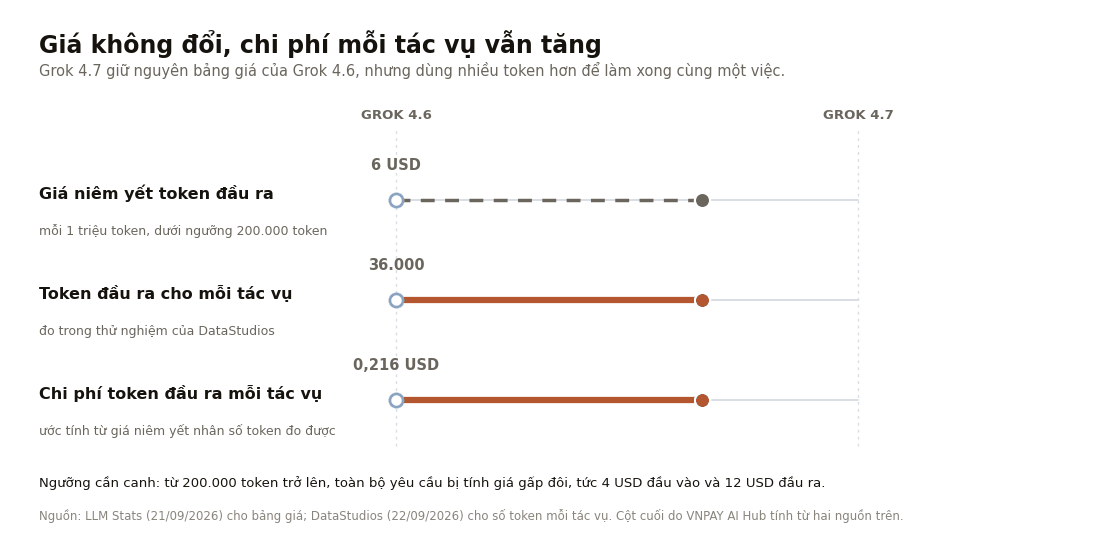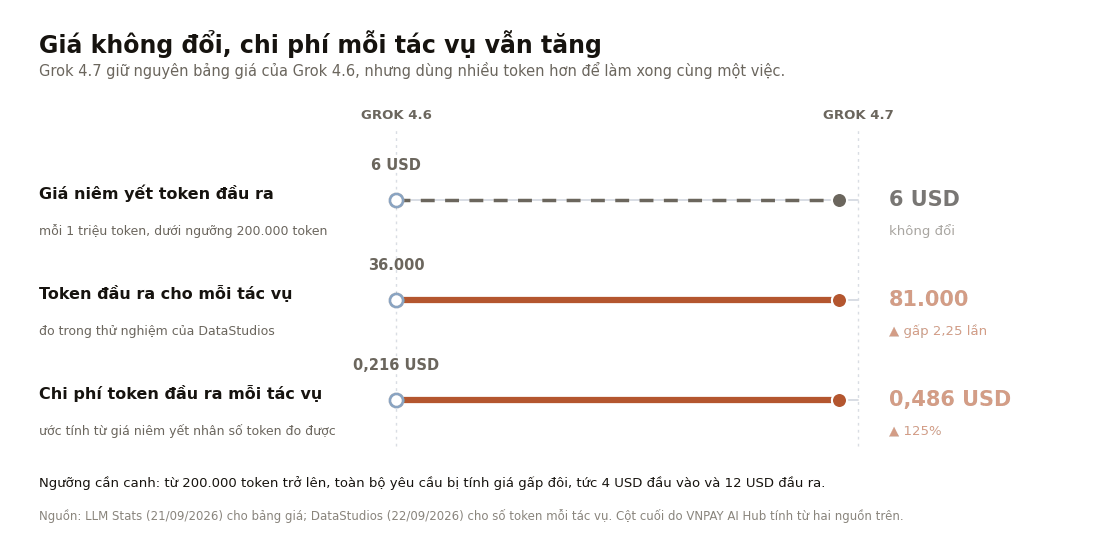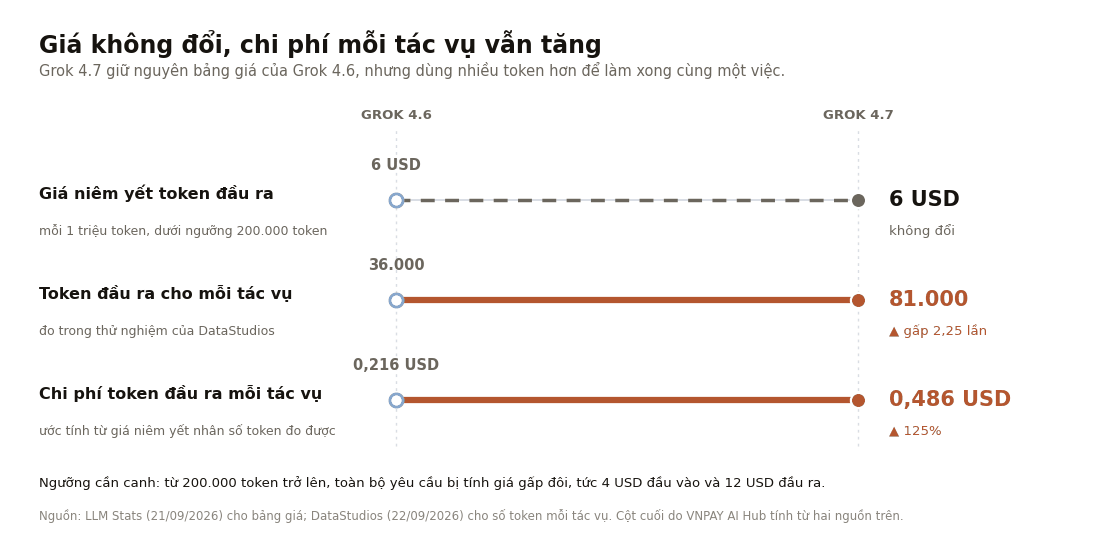
Nói cách khác, bảng giá giữ nguyên nhưng số tiền thực trả cho mỗi việc hoàn thành lại tăng. Với mức giá 6 USD cho mỗi triệu token đầu ra, chênh lệch 36.000 và 81.000 token tương đương khoảng 0,216 USD so với 0,486 USD cho mỗi tác vụ.
DigitalApplied bổ sung rằng các kết quả benchmark được công bố không kèm khoảng sai số, và không có bên thứ ba nào xác thực [6]. LLM Stats cũng khuyến nghị đo lại số token cho mỗi tác vụ trước khi mở rộng lưu lượng [2].
Một chi tiết về xung đột lợi ích mà OfficeChai chỉ ra: CursorBench là benchmark do Cursor xây dựng, và Cursor đã được chính SpaceXAI mua lại trước đó không lâu [5]. Điều này không có nghĩa kết quả sai, nhưng là thông tin người đọc cần biết khi đánh giá.
Những thông tin chưa được xác nhận
Hai chi tiết được nhắc nhiều trên mạng cần được tách bạch với các dữ kiện ở trên:
- Số tham số 2,1 nghìn tỷ. Decrypt đưa con số này cùng mức tăng 40% so với Grok 4.6 [3]. Tuy nhiên, DataStudios cho biết con số này xuất phát từ bài đăng mạng xã hội chứ không phải tài liệu chính thức của công ty [7]. Model card không nêu số tham số [1].
- Dữ liệu huấn luyện từ SpaceX. Decrypt cho biết mô hình được huấn luyện bổ sung bằng dữ liệu của SpaceX như telemetry vệ tinh Starlink, hồ sơ sản xuất và nhật ký lỗi kỹ thuật, nhằm cải thiện khả năng suy luận về hệ thống vật lý và phần cứng [3]. Model card chính thức không nhắc tới nguồn dữ liệu này, chỉ nêu mô hình được pretraining trên dữ liệu công khai cùng các tập dữ liệu độc quyền [1].
Khi trích dẫn lại hai chi tiết này, nên ghi rõ nguồn và tình trạng chưa được hãng xác nhận.
Ai dùng được, và dùng ở đâu
Grok 4.7 có mặt trên API của SpaceXAI, Cursor (tất cả các gói), Grok Build, OpenRouter, Vercel và Cloudflare [4]. DigitalApplied cho biết mô hình cũng đã được bổ sung vào GitHub Copilot, dùng được trong VS Code, Visual Studio, CLI, JetBrains, Xcode và Eclipse [6]. Bản chạy nhanh chỉ có trên Cursor và Grok Build [4][6].
Về an toàn, model card công bố tỉ lệ vi phạm bằng 0,0% ở nhóm bài kiểm tra an toàn trẻ em, tỉ lệ từ chối 100% với nhóm câu hỏi liên quan vũ khí sinh học, và tỉ lệ tuân theo yêu cầu jailbreak ở mức 0,01% với các dạng tấn công phổ biến [1]. Đây là số liệu tự công bố.
Cần thận trọng
- Không dựa vào một nguồn số liệu duy nhất. Trường hợp Grok 4.7 cho thấy điểm nhà cung cấp và chỉ số độc lập có thể đi ngược chiều nhau [6][7].
- Giá token không đổi không có nghĩa chi phí không đổi. Khi số token cho mỗi tác vụ tăng 2,25 lần, hóa đơn tăng theo [7].
- Ngưỡng 200.000 token là một bẫy chi phí. Vượt ngưỡng, cả yêu cầu bị tính giá gấp đôi [2].
- Kiểm tra mức suy luận khi so sánh. Hai con số chạy ở hai mức effort khác nhau không so sánh được với nhau [7].
- Đối chiếu giá theo đường dẫn truy cập. Giá qua API trực tiếp, qua OpenRouter hay qua endpoint khu vực có thể khác nhau [4][6].
Ý nghĩa với chúng ta
Với phần lớn nhân viên, đây là tin mang tính tham khảo, không cần thao tác gì.
Với các đội đang chọn mô hình cho sản phẩm hoặc quy trình nội bộ, bản phát hành này để lại bốn bài học có thể áp dụng cho mọi nhà cung cấp, không riêng SpaceXAI:
- Chạy thử trên chính công việc của mình trước khi chuyển đổi. Một bản nâng cấp có số hiệu cao hơn không đảm bảo kết quả tốt hơn cho tác vụ cụ thể của đội. Cách kiểm chứng rẻ nhất là giữ một bộ khoảng 20 đến 50 tình huống thật, đã có đáp án đúng, và chạy lại mỗi lần đổi mô hình.
- Đo chi phí cho mỗi công việc hoàn thành, không đo giá token. Cần theo dõi số token đầu ra trung bình cho mỗi tác vụ, tỉ lệ phải chạy lại và tỉ lệ hoàn thành.
- Đọc kỹ cấu trúc giá theo ngưỡng. Với các tác vụ đưa vào tài liệu dài, việc vô tình vượt ngưỡng ngữ cảnh có thể làm chi phí tăng gấp đôi mà không ai nhận ra cho tới khi nhận hóa đơn.
- Lưu ý ai là người tạo ra benchmark. Khi một phép đo do chính bên bán hoặc công ty con của họ xây dựng, kết quả cần được đối chiếu thêm.
Riêng với môi trường fintech, khuyến cáo trong model card đáng được ghi nhận: chính nhà cung cấp nêu rõ mô hình không phù hợp cho các quyết định tự động trong lĩnh vực tài chính khi không có con người giám sát [1]. Điều này phù hợp với nguyên tắc nội bộ: AI hỗ trợ soạn và đề xuất, con người xem xét và chịu trách nhiệm.
Lưu ý an toàn dữ liệu: không đưa dữ liệu khách hàng, thông tin giao dịch hay tài liệu nội bộ của VNPAY vào công cụ AI chưa được phê duyệt. Với mô hình có tính năng tìm kiếm trên mạng xã hội và thực thi mã như Grok, đội kỹ thuật cần rà kỹ phạm vi quyền được cấp trước khi tích hợp. Đây là gợi ý chung, các yêu cầu cụ thể cần xác nhận với bộ phận Pháp chế và An toàn thông tin.
Grok 4.7 không phải mô hình dẫn đầu ở nhóm benchmark lập trình, và cũng không tự nhận như vậy. Giá trị của bản phát hành này với người đọc nằm ở chỗ khác: nó là ví dụ rõ ràng cho thấy khoảng cách giữa con số trong thông cáo và kết quả khi chạy thật, và vì sao mỗi đội cần bộ kiểm thử của riêng mình.
References
- SpaceXAI — Model Card: Grok 4.7 (21/09/2026). Available at: https://media.x.ai/v1/website/4p7card-5eccc980.pdf (Accessed: 23/09/2026).
- LLM Stats — Grok 4.7 Release: Same Price, Longer Horizons (21/09/2026). Available at: https://llm-stats.com/blog/research/grok-4-7-launch (Accessed: 23/09/2026).
- Lanz, J. A. — Decrypt, xAI Launches Grok 4.7. It's Bigger, But Late to the AI Frontier Party (21/09/2026). Available at: https://decrypt.co/378824/xai-launches-grok-4-7 (Accessed: 23/09/2026).
- MarkTechPost — SpaceXAI Releases Grok 4.7: A Larger Base Model at the Same $2/$6 Price as Grok 4.6 (21/09/2026). Available at: https://www.marktechpost.com/2026/09/21/spacexai-releases-grok-4-7/ (Accessed: 23/09/2026).
- OfficeChai — SpaceXAI Launches Grok 4.7, Beats GPT-5.6 Sol And Fable 5.1 On Some Benchmarks (21/09/2026). Available at: https://officechai.com/ai/grok-4-7-benchmarks/ (Accessed: 23/09/2026).
- DigitalApplied — Grok 4.7 Costs the Same as 4.6. What Actually Changed (21/09/2026). Available at: https://www.digitalapplied.com/blog/grok-4-7-benchmarks-price-what-changed (Accessed: 23/09/2026).
- DataStudios — Grok 4.6 vs Grok 4.7: Complete Comparison and Report on Pricing, Benchmarks, Independent Testing (22/09/2026). Available at: https://www.datastudios.org/post/grok-4-6-vs-grok-4-7-complete-comparison-and-report-on-pricing-benchmarks-independent-testing-an (Accessed: 23/09/2026).