
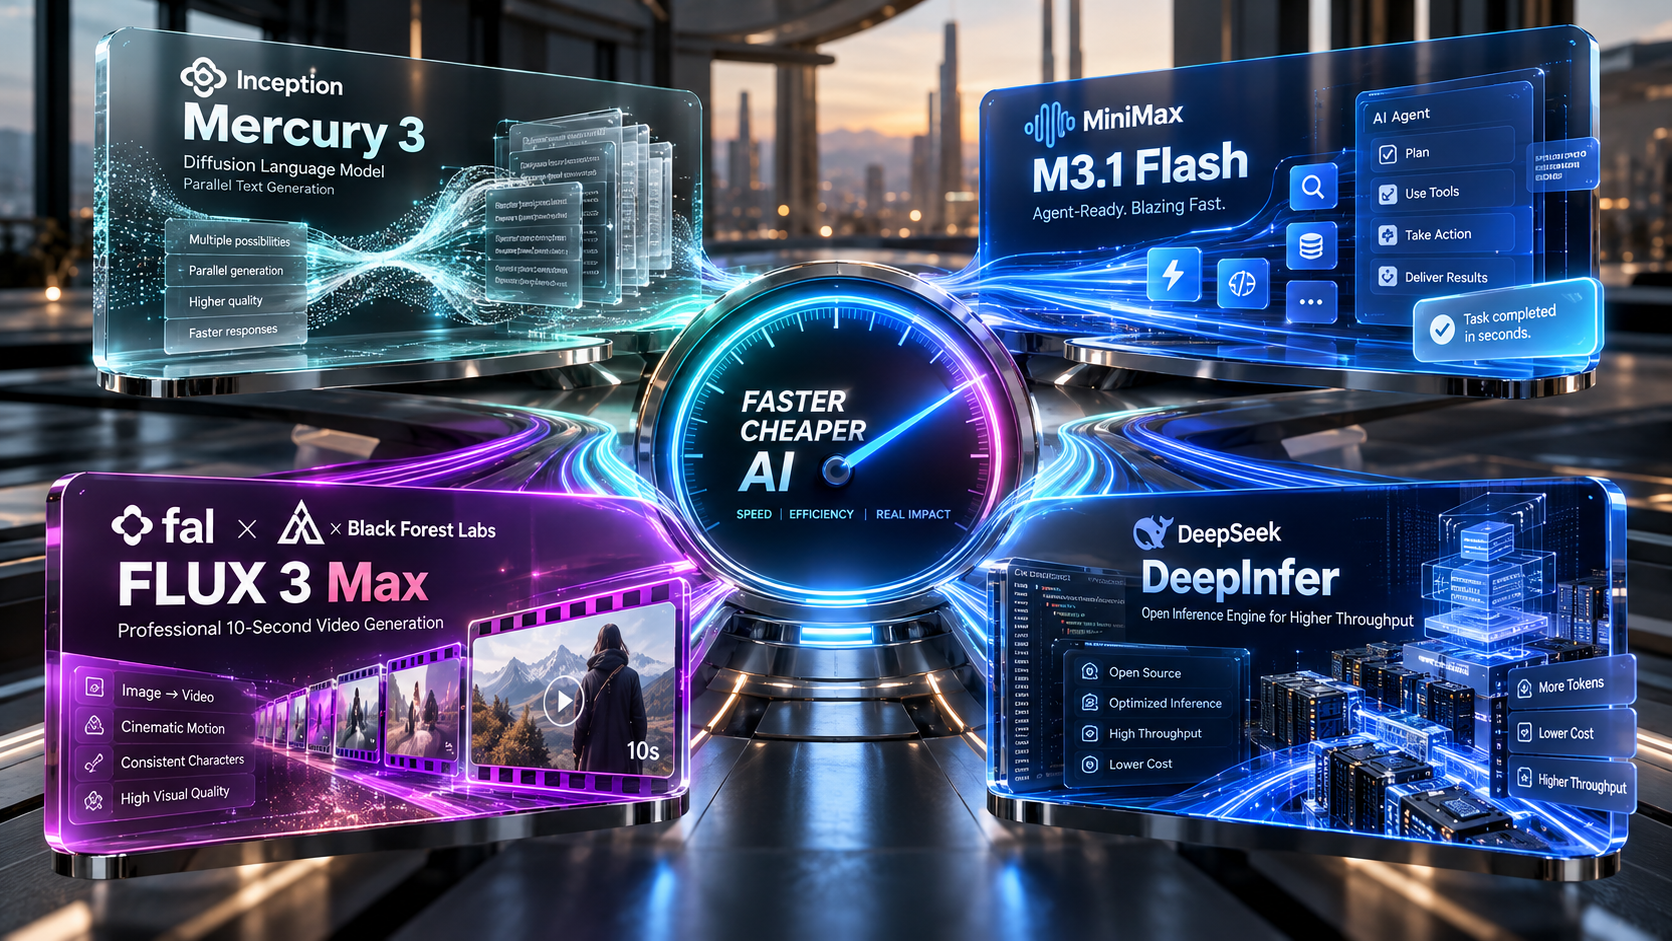
Trong hai ngày 19–20/10/2026, bốn công bố từ bốn đơn vị khác nhau có chung một điểm nhấn: làm AI chạy nhanh hơn và rẻ hơn. Inception ra mắt Mercury 3, mô hình ngôn ngữ dùng kỹ thuật diffusion với tốc độ hãng công bố trên 1.000 token mỗi giây [1]. MiniMax chính thức phát hành M3.1 Flash, nhắm vào tác vụ agent với chi phí thấp [6]. Nền tảng fal cùng Black Forest Labs giới thiệu FLUX 3 Max, tạo một video 10 giây trong khoảng 12 giây [8][9]. DeepSeek thì mở mã nguồn DeepInfer, engine suy luận đang chạy các dịch vụ của chính công ty [12][13]. Điểm chung cần lưu ý: hầu hết số liệu hiệu năng đều do các hãng tự công bố.
Mercury 3: sinh văn bản bằng diffusion
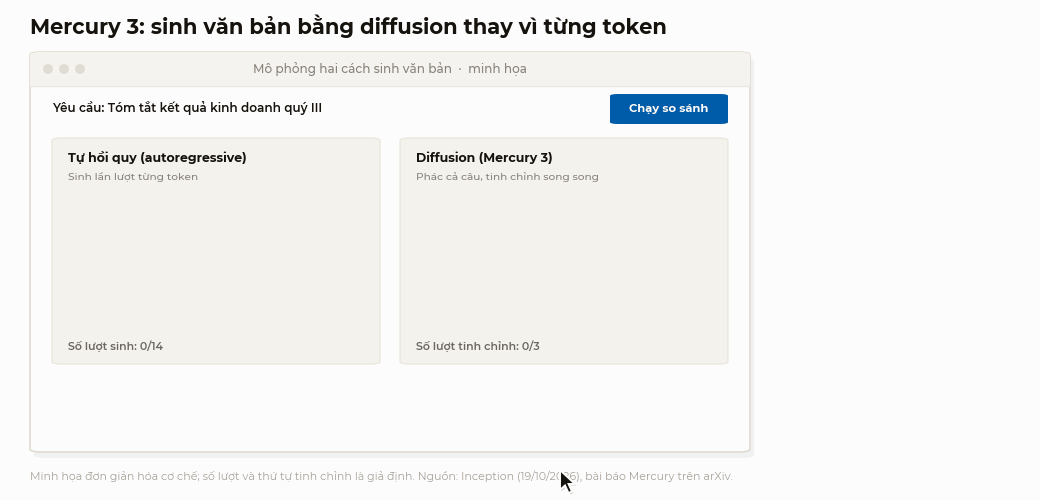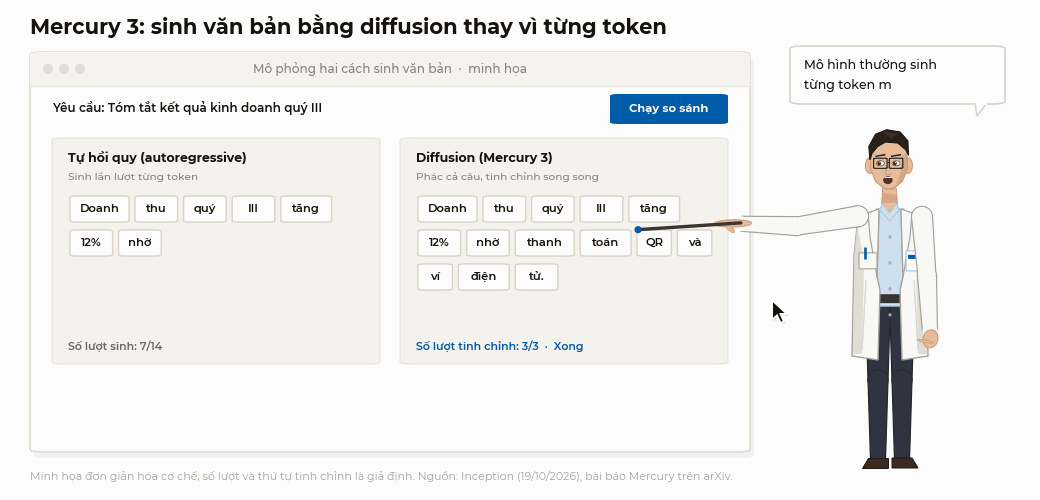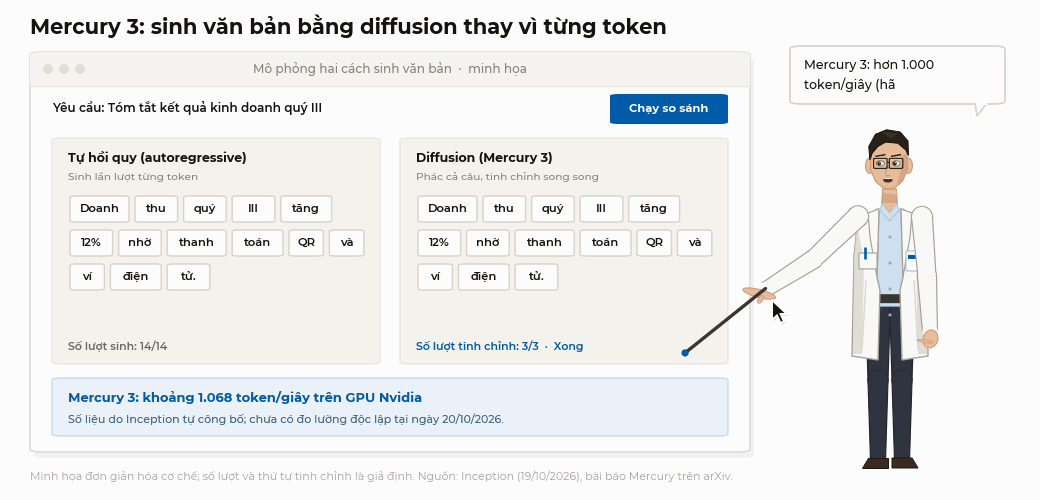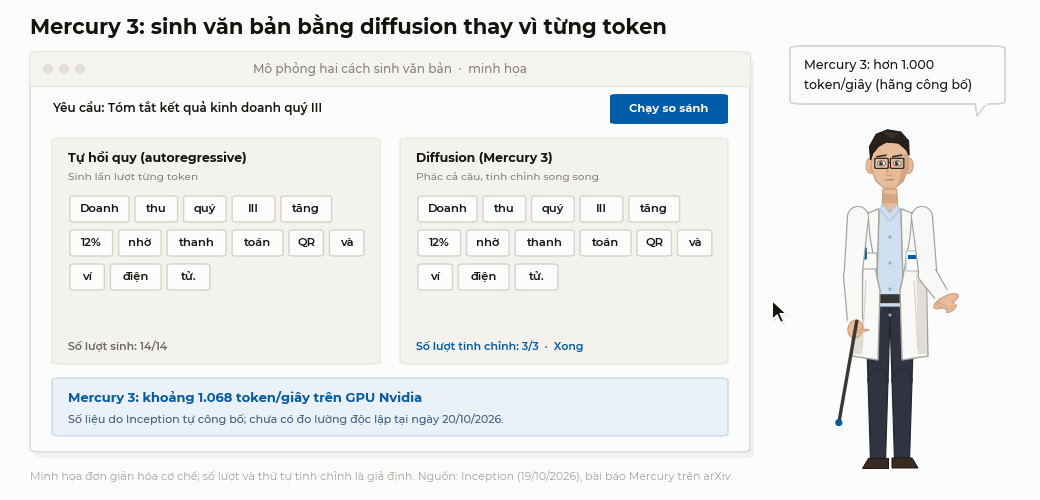
Diffusion khác gì cách làm thông thường. Phần lớn mô hình ngôn ngữ hiện nay là mô hình tự hồi quy (autoregressive): sinh văn bản lần lượt từng token, token sau phụ thuộc token trước. Mô hình ngôn ngữ dạng diffusion của Inception làm khác: phác thảo nhiều phần của câu trả lời cùng lúc rồi tinh chỉnh song song qua một số lượt, từ thô đến chi tiết [2][4]. Vì số lượt ít hơn số token, cách này có thể nhanh hơn đáng kể trên cùng phần cứng.
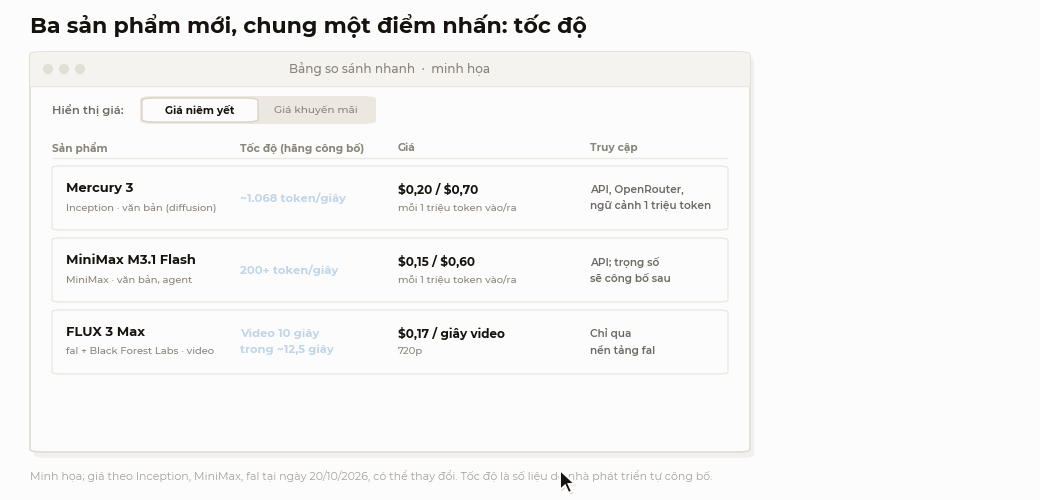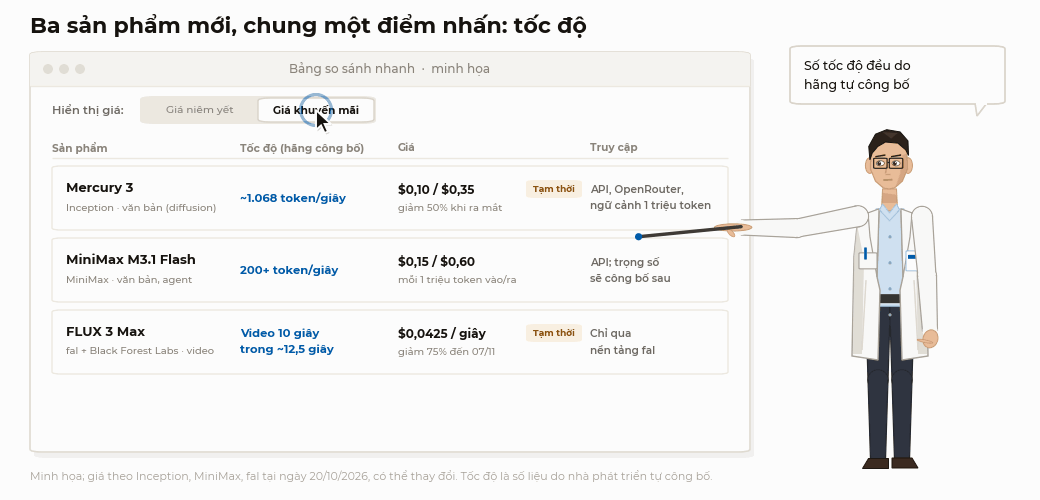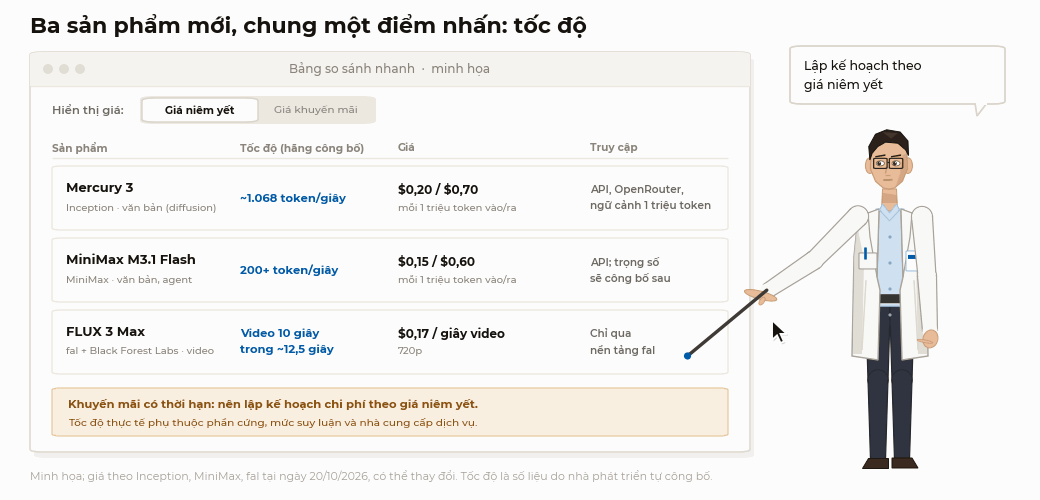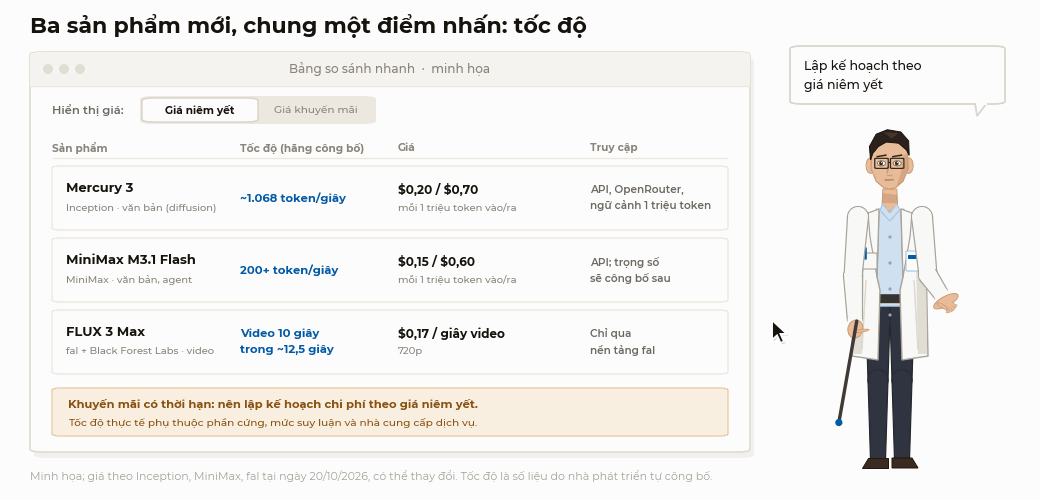
Mercury 3 ra mắt ngày 19/10/2026, là mô hình chủ lực của Inception [1][5]. Các thông số chính theo Inception và các nguồn đưa tin [1][2][3]:
- Quy mô: tổng số tham số gấp hơn 40 lần Mercury 1, nhưng không công bố con số cụ thể. Inception cho biết năng lực tổng hợp tăng khoảng 3 lần so với Mercury 1 bản mini.
- Tốc độ: khoảng 1.068 token/giây trên GPU Nvidia, nhanh hơn 4–8 lần các mô hình tương đương theo hãng. OrcaRouter lưu ý Inception chưa nêu loại phần cứng, kích thước lô (batch) hay mức suy luận khi đo [3].
- Ngữ cảnh: 1 triệu token, tăng từ 260.000 token ở Mercury 2.5; đầu ra tối đa 131.072 token. Chỉ nhận và trả về văn bản.
- Tính năng: gọi công cụ, đầu ra có cấu trúc, API tương thích OpenAI. Có bốn mức suy luận (instant, low, medium, high), mặc định là low.
- Giá: niêm yết 0,20 USD/1 triệu token đầu vào và 0,70 USD/1 triệu token đầu ra; giảm 50% khi ra mắt (0,10 USD và 0,35 USD), chưa công bố ngày kết thúc khuyến mãi. Tài khoản mới được tặng 100 triệu token.
- Truy cập: qua nền tảng API của Inception, OpenRouter, Baseten, Vercel. Mercury 2 và 2.5 ngừng nhận người dùng mới; khách hàng cũ dùng được đến 15/11/2026.
Về chất lượng, Inception khẳng định Mercury 3 vượt GPT-6 Luna và Claude Haiku 5.5 trên một loạt bài kiểm tra [1]. Theo The Neuron, các điểm hãng công bố cho thấy Mercury 3 dẫn trên BrowseComp+ (55,18, so với 50,50 của Luna và 45,78 của Haiku 5.5), nhưng Haiku 5.5 dẫn trên DeepSWE v1 và MRCR v2 [2]. Trong một thử nghiệm tự chạy với 50 tác vụ duyệt web thực tế (Mind2Web), Mercury 3 hoàn thành 50% [1]. Tại ngày 20/10, Artificial Analysis chưa có trang đo lường Mercury 3; với Mercury 2.5, tổ chức này từng đo được khoảng 706 token/giây [3].
The Neuron chạy thử 8 tác vụ qua OpenRouter với tổng chi phí khoảng 0,04 USD. Mô hình làm tốt bài toán kinh doanh, lập trình và câu đố logic, nhưng đôi khi lệch yêu cầu về độ dài, nhầm thuật ngữ và giải thích quá tự tin [2].
MiniMax M3.1 Flash: mô hình agent giá rẻ
MiniMax công bố chính thức M3.1 Flash ngày 19/10/2026 [6]. Trước đó, từ cuối tháng 9, mô hình đã có ở dạng xem trước trong MiniMax Code và gói Token Plan [7]. MiniMax cho biết một phiên bản sớm của M3.1 Flash từng chạy ẩn danh với tên "Space Bunny" và đã xử lý hơn 200.000 tỷ token [6]; theo The Neuron, công cụ lập trình OpenCode là nơi tiết lộ danh tính này [15].
- Tốc độ và chi phí (hãng công bố): suy luận trực tuyến nhanh gần gấp 3 lần; tốc độ đầu ra thường ngày trên 200 token/giây, trung vị trên 170 token/giây; tổng chi phí cho tác vụ agent thấp hơn 70% so với thế hệ trước [6].
- Giá: 0,15 USD/1 triệu token đầu vào, 0,60 USD/1 triệu token đầu ra, 0,015 USD cho đầu vào lưu đệm [6].
- Benchmark (hãng công bố): BankerToolBench 76,2; DeepSWE v1.1 73,7%; OSWorld V2 61,7 và Agents' Last Exam 29,6, cả hai được MiniMax cho là cao nhất trong các mô hình Trung Quốc; CyberGym 82% [6].
- Thông số bản xem trước: ngữ cảnh 1 triệu token, nhận văn bản, hình ảnh và video; có các mức suy luận từ low đến max và không tắt được chế độ suy nghĩ [7].
- Truy cập: qua API của MiniMax, gói M Plan và MiniMax Code. Trọng số chưa được công bố, MiniMax cho biết sẽ phát hành sau, cùng với bản Pro mạnh hơn [6].
FLUX 3 Max: video 10 giây trong khoảng 12 giây
FLUX 3 Max ra mắt ngày 19/10/2026 trên nền tảng suy luận fal [8][11]. Đây là sản phẩm hợp tác: Black Forest Labs phát triển mô hình nền FLUX 3, còn nhóm nghiên cứu của fal huấn luyện thêm để tăng độ trung thực hình ảnh, độ mạch lạc của chuyển động và mức bám sát yêu cầu [8]. FLUX 3 Video bản gốc đã được Black Forest Labs phát hành rộng rãi từ tháng 8/2026, tạo được clip tới 20 giây kèm âm thanh [10].
- Tốc độ (fal công bố): trung bình 12,45 giây để tạo một video 720p dài 10 giây. Con số này nhanh hơn khoảng 22 lần Seedance 2.5 (277,80 giây) và khoảng 10 lần FLUX 3 gốc (126,44 giây) [9].
- Chất lượng: fal cho biết FLUX 3 Max đồng hạng nhất trên bảng xếp hạng chuyển ảnh thành video của Artificial Analysis với 1.139 điểm Elo (sơ bộ). Unite.AI ghi nhận bảng xếp hạng đang đặt mô hình này ở vị trí thứ hai, sau MiniMax H3, với khoảng cách rất nhỏ [8][9].
- Chế độ: tạo video từ văn bản và từ ảnh, độ phân giải 720p. Trang sản phẩm không nhắc đến âm thanh [9].
- Giá: niêm yết 0,17 USD cho mỗi giây video; đang giảm 75% còn 0,0425 USD/giây đến hết ngày 07/11/2026. Tính tiền theo giây, không có mức tối thiểu hay gói thuê bao [9].
- Truy cập và bản quyền: chỉ qua API của fal; nội dung tạo ra được dùng cho mục đích thương mại theo điều khoản của fal [8][9].
DeepInfer: DeepSeek mở mã nguồn engine suy luận
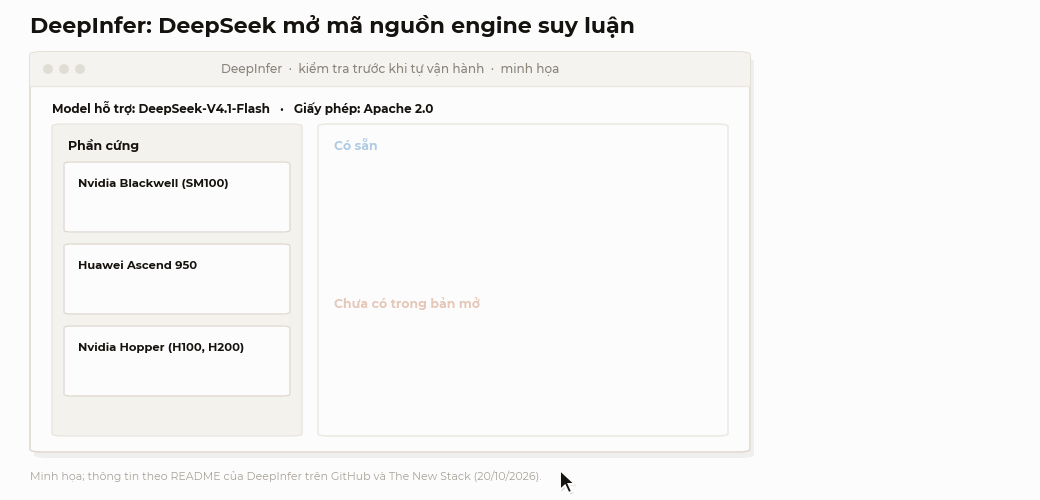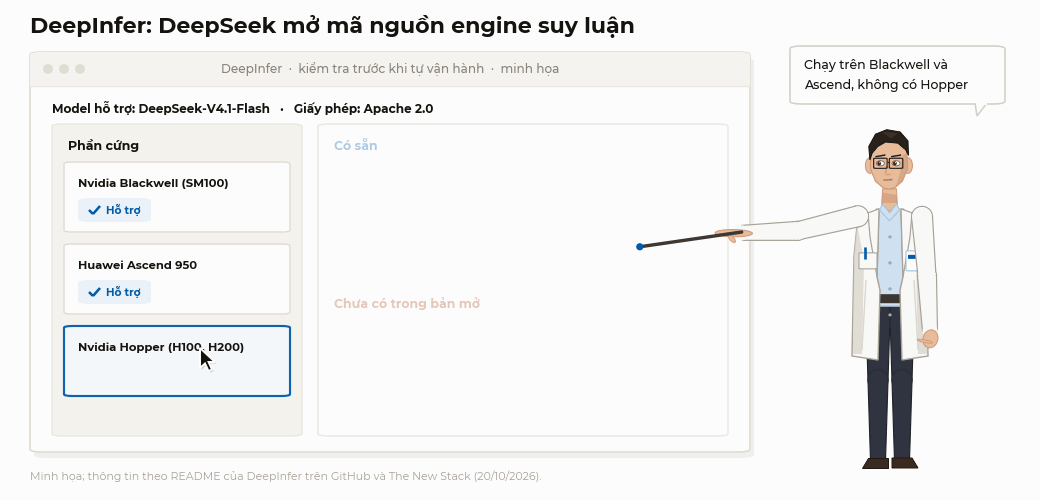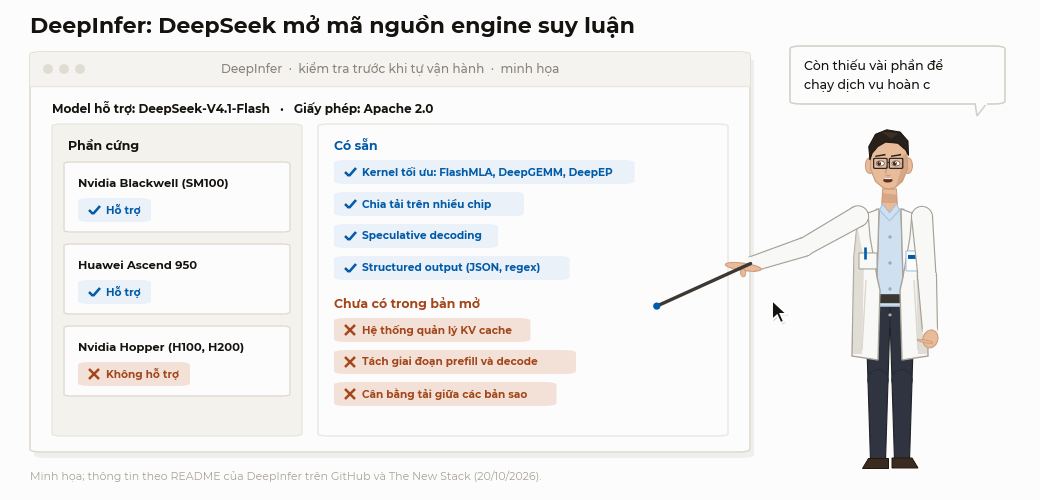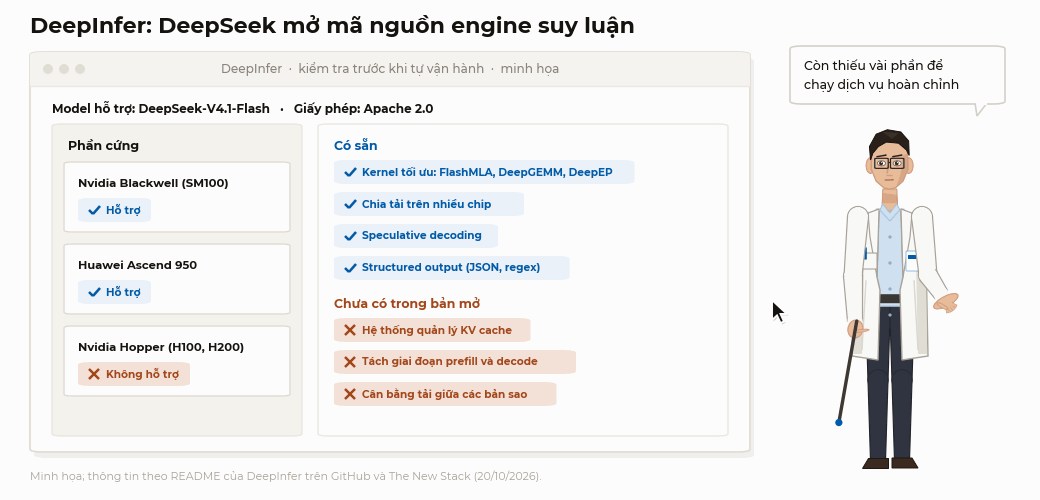
Ngày 20/10/2026, DeepSeek công bố mã nguồn DeepInfer, framework suy luận mà công ty dùng để vận hành các dịch vụ của mình, theo giấy phép Apache 2.0 [12][13]. DeepSeek cho biết mục tiêu là giúp cộng đồng giảm chi phí tính toán và năng lượng [13]. Theo The Next Web, DeepInfer được xây chủ yếu trên vLLM, có đóng góp từ SGLang và TensorRT-LLM; kho mã đạt hơn 8.000 sao trên GitHub ngay trong buổi chiều đầu tiên [14].
- Mô hình hỗ trợ: hiện chỉ có DeepSeek-V4.1-Flash; DeepSeek dự kiến hỗ trợ các mô hình sau này [12][13].
- Phần cứng: GPU Nvidia kiến trúc SM100 (dòng Blackwell cho trung tâm dữ liệu) và chip Huawei Ascend 950. Không hỗ trợ các dòng cũ như Hopper (H100, H200) [13].
- Có sẵn: các kernel tối ưu (FlashMLA, DeepGEMM, DeepEP), cơ chế chia tải trên nhiều chip, speculative decoding (đoán trước và kiểm tra nhiều token cùng lúc), lập lịch bất đồng bộ, đầu ra có cấu trúc. Riêng trên phần cứng Nvidia có thêm suy luận cho kết quả nhất quán giữa các lần chạy [12][13].
- Chưa có trong bản mở: hệ thống quản lý KV cache, tách hai giai đoạn prefill và decode ra các máy khác nhau, cân bằng tải giữa các bản sao. Chính README ghi các thành phần này là cần thiết cho một dịch vụ hoàn chỉnh [12].
- Hiệu năng: DeepSeek chỉ công bố biểu đồ, đo trên 4 GPU SM100 cho prefill và 64 GPU cho decode; không có số liệu thông lượng, độ trễ hay chi phí cụ thể, và chưa có kiểm thử độc lập [12][14].
The New Stack đánh giá điểm đáng chú ý nhất là chip Huawei được hỗ trợ ngang hàng với Nvidia ngay từ đầu, trong bối cảnh Mỹ hạn chế xuất khẩu chip tiên tiến sang Trung Quốc [13]. Một ngày trước khi DeepInfer được công bố, chính phủ Mỹ yêu cầu các cơ quan dân sự liên bang gỡ bỏ sản phẩm của DeepSeek khỏi hệ thống [14][15].
Thông tin chính thức từ các hãng:
- Inception (qua Unite.AI và các nguồn thuật lại), MiniMax (blog chính thức), fal (trang sản phẩm), DeepSeek (README trên GitHub) [1][6][9][12].
Nguồn bên ngoài:
- The Neuron: chạy thử Mercury 3 [2]; OrcaRouter: phân tích các điểm còn thiếu trong công bố của Mercury 3 [3]; eesel.ai: thông số bản xem trước M3.1 Flash [7]; Unite.AI, The Decoder: bối cảnh FLUX 3 [8][10]; The New Stack, The Next Web: DeepInfer [13][14].
- Chưa có đo lường độc lập cho tốc độ của Mercury 3, MiniMax M3.1 Flash hay hiệu năng của DeepInfer.
Ba điểm không nên đọc lệch:
- Tốc độ công bố không phải tốc độ bạn sẽ nhận được. Con số phụ thuộc phần cứng, kích thước lô, mức suy luận và nhà cung cấp; với Mercury 2.5, số đo độc lập từng thấp hơn số hãng công bố [3].
- Giá khuyến mãi có thời hạn. Mercury 3 và FLUX 3 Max đều đang giảm giá khi ra mắt; lập kế hoạch nên dựa trên giá niêm yết [1][9].
- Mã nguồn mở không đồng nghĩa với sẵn sàng vận hành. DeepInfer còn thiếu một số thành phần quan trọng cho dịch vụ thật, và chỉ chạy trên phần cứng thế hệ mới [12][13].
Ý nghĩa với chúng ta
Các gợi ý dưới đây là góc nhìn chung, team cần đối chiếu với quy trình và chính sách thực tế của VNPAY (an toàn thông tin, quản trị dữ liệu, mua sắm công nghệ).
- Mô hình nhanh, rẻ hợp với các tác vụ khối lượng lớn, độ trễ thấp, như phân loại yêu cầu, trích xuất thông tin, trợ lý trả lời nhanh. Với tác vụ mà sai sót gây hậu quả lớn, cần thử kỹ trên chính dữ liệu của team trước khi dùng.
- Tự đo trước khi chọn. Nên chạy thử cùng một bộ tác vụ trên vài mô hình, đo độ trễ, tỷ lệ đúng và chi phí thực tế, thay vì dựa vào bảng so sánh của hãng.
- Lưu ý nguồn gốc và nơi xử lý dữ liệu. MiniMax và DeepSeek là doanh nghiệp Trung Quốc; khi gọi qua API, dữ liệu được xử lý trên hạ tầng của họ. DeepSeek cũng vừa bị chính phủ Mỹ yêu cầu gỡ khỏi hệ thống các cơ quan liên bang [14]. Mọi kế hoạch sử dụng cần qua bộ phận an toàn thông tin và pháp chế.
- Ghi nhận bài kiểm tra BankerToolBench. MiniMax công bố điểm trên bộ kiểm tra dành cho tác vụ ngân hàng [6]. Đây là dấu hiệu các hãng bắt đầu tối ưu cho tác vụ tài chính; có thể theo dõi bộ kiểm tra này khi đánh giá mô hình cho nghiệp vụ.
- Video ngắn cho truyền thông nội bộ đang rẻ và nhanh hơn. Với giá niêm yết, một clip 10 giây từ FLUX 3 Max khoảng 1,7 USD [9]; vẫn cần kiểm tra điều khoản sử dụng và tránh đưa hình ảnh, thông tin nội bộ nhạy cảm vào yêu cầu.
References
- Unite.AI — Inception Releases Mercury 3, Its Flagship Diffusion LLM (19/10/2026). Available at: https://www.unite.ai/inception-releases-mercury-3-its-flagship-diffusion-llm/ (Accessed: 21/10/2026).
- The Neuron — Mercury 3 Review: Inception's Diffusion AI Put to the Test (10/2026). Available at: https://www.theneuron.ai/news/mercury-3-review-diffusion-language-models/ (Accessed: 21/10/2026).
- OrcaRouter — Mercury 3: 1,068 Tokens a Second, and No Benchmarks (10/2026). Available at: https://www.orcarouter.ai/blog/inception-mercury-3 (Accessed: 21/10/2026).
- Inception Labs — Mercury: Ultra-Fast Language Models Based on Diffusion (arXiv, 2025). Available at: https://arxiv.org/abs/2506.17298 (Accessed: 21/10/2026).
- Stefano Ermon (Inception) — Bài đăng công bố Mercury 3 trên X (19/10/2026). Available at: https://x.com/StefanoErmon/status/2112222911218291051 (Accessed: 21/10/2026; không mở được trực tiếp).
- MiniMax — MiniMax M3.1 Flash (19/10/2026). Available at: https://www.minimax.io/blog/minimax-m31f (Accessed: 21/10/2026).
- eesel.ai — MiniMax M3.1 Flash : specs, tarifs et comment tester la preview (28/09/2026). Available at: https://www.eesel.ai/fr/blog/minimax-m3-1-flash-specs-tarifs-tester-preview (Accessed: 21/10/2026).
- Unite.AI — Fal Debuts FLUX 3 Max Video Model Post-Trained With Black Forest Labs (19/10/2026). Available at: https://www.unite.ai/fal-debuts-flux-3-max-video-model-post-trained-with-black-forest-labs/ (Accessed: 21/10/2026).
- fal — FLUX 3 Max: Text and Image to Video, Post-Trained by fal. Available at: https://fal.ai/flux-3-max (Accessed: 21/10/2026).
- The Decoder — Black Forest Labs makes FLUX 3 Video generally available and claims it beats Seedance 2.0 (05/08/2026). Available at: https://the-decoder.com/black-forest-labs-makes-flux-3-video-generally-available-and-claims-it-beats-seedance-2-0/ (Accessed: 21/10/2026).
- Black Forest Labs — Introducing FLUX 3 Max (bài đăng trên X, 19/10/2026). Available at: https://x.com/bfl_ai/status/2112255353677328415 (Accessed: 21/10/2026; không mở được trực tiếp).
- DeepSeek — DeepInfer (kho mã GitHub, README). Available at: https://github.com/deepseek-ai/DeepInfer (Accessed: 21/10/2026).
- The New Stack — DeepSeek open-sources the inference engine behind its API. And Huawei gets equal billing with Nvidia. (20/10/2026). Available at: https://thenewstack.io/deepseek-deepinfer-huawei-nvidia/ (Accessed: 21/10/2026).
- The Next Web — DeepSeek open-sources DeepInfer, the engine that runs its AI models (20/10/2026). Available at: https://thenextweb.com/news/deepseek-deepinfer-open-source-inference-engine (Accessed: 21/10/2026).
- The Neuron — Everything That Happened in AI Today, Tuesday, October 20, 2026. Available at: https://www.theneuron.ai/digest/everything-that-happened-in-ai-today-tuesday-october-20-2026/ (Accessed: 21/10/2026).