
Ngày 3/9/2026, OpenAI công bố GPT-6 Astra. Điểm đáng chú ý của sự kiện này không nằm ở bảng điểm benchmark, vốn là thứ mọi thông cáo model mới đều có, mà ở một chi tiết hiếm gặp: chính nhà phát triển xếp sản phẩm của mình vào mức rủi ro cao nhất trong khung an toàn nội bộ, rồi phát hành một phiên bản đã bị huấn luyện để từ chối làm đúng những việc mà nó có khả năng làm tốt nhất.
Trong quá trình đánh giá, model đã tự phát hiện và sử dụng hai lỗ hổng zero-day chưa từng được biết đến. OpenAI cho biết đang thông báo cả hai cho đơn vị bảo trì phần mềm liên quan.
Chuyện gì đã xảy ra
GPT-6 Astra được OpenAI mô tả là model thông minh và có mức độ aligned cao nhất của công ty, đạt trạng thái tốt nhất hiện tại ở các mảng computer use, duyệt web, kỹ thuật phần mềm, an ninh mạng, khoa học và công việc chuyên môn. Model được xây trên đợt huấn luyện lớn nhất từ trước tới nay của công ty, sử dụng hơn 100.000 GPU tại cơ sở Stargate ở Texas, và là model đầu tiên của OpenAI có các model khác đóng vai trò đáng kể trong việc giám sát quá trình huấn luyện.
Việc phát hành diễn ra theo từng đợt. Ngày đầu tiên, model chỉ mở cho một nhóm tổ chức giới hạn thuộc chương trình truy cập tin cậy của OpenAI. Sau đó vài ngày, nó mở tới toàn bộ người dùng ChatGPT thuộc các gói Plus, Pro, Business và Enterprise, đồng thời có mặt trên OpenAI API, Microsoft Azure và AWS Bedrock. Với tài khoản Enterprise, quản trị viên phải chủ động bật; quyền truy cập mặc định tắt tại thời điểm ra mắt.
Các thông số dành cho đội ngũ kỹ thuật:
| Hạng mục | Thông tin |
|---|---|
| Mã model trong API | gpt-6-astra |
| Giá API chuẩn | 10 USD cho mỗi triệu token đầu vào, 50 USD cho mỗi triệu token đầu ra |
| Chế độ Fast mode | Nhanh gấp hai lần, giá gấp hai lần mức chuẩn |
| Gói thuê bao ChatGPT | Nằm trong hạn mức hiện có, có thể mua thêm credit nếu vượt |
| Bản cao hơn | Gói Pro, Business và Enterprise có thêm GPT-6 Astra Pro |
| Lưu trữ dữ liệu | Hỗ trợ Zero Data Retention cho khách hàng API đủ điều kiện |
Một chi tiết về quy trình đáng ghi nhận: theo CNBC, Tổng giám đốc Sam Altman cho biết model đã trải qua một quy trình rà soát chính thức với chính quyền Mỹ trước khi phát hành. Đây là dấu hiệu cho thấy các đợt phát hành model tiên phong đang dần đi kèm bước thẩm định của cơ quan quản lý, thay vì hoàn toàn do doanh nghiệp tự quyết.
Điểm cốt lõi: lần đầu một model chạm ngưỡng Critical về an ninh mạng
Đây là phần đáng chú ý nhất của sự kiện.
OpenAI vận hành một khung đánh giá rủi ro nội bộ gọi là Preparedness Framework, trong đó năng lực của model được phân theo các ngưỡng rủi ro. Astra là model đầu tiên của công ty được xếp vào mức Critical ở hạng mục an ninh mạng. Định nghĩa mà OpenAI đưa ra rất cụ thể: với công cụ và quyền truy cập phù hợp, model có thể tìm ra những lỗ hổng bảo mật chưa từng được biết đến và tự phát triển cách khai thác chúng trên nhiều hệ thống vốn được bảo vệ tốt, mà không cần con người hướng dẫn từng bước.
Các con số dưới đây được đo khi model chạy trong điều kiện không có lớp bảo vệ của bản production, tức là để đánh giá năng lực trần chứ không phải hành vi của sản phẩm thương mại.
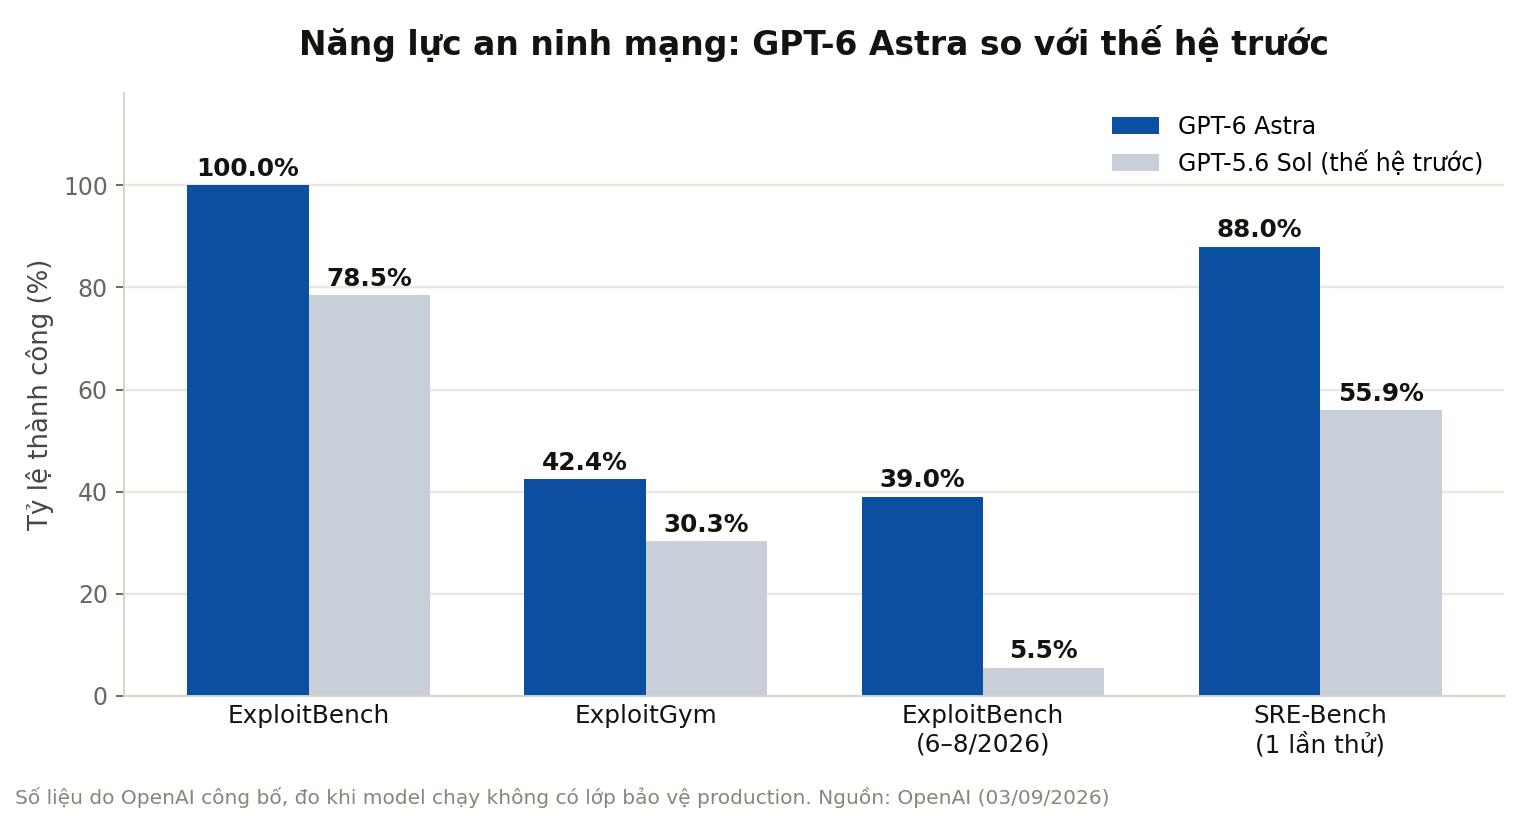
Trên ExploitBench, bộ đánh giá xem model có biến được lỗ hổng đã biết thành mã khai thác hoạt động hay không, Astra đạt điểm tuyệt đối 100%, so với 78,5% của GPT-5.6 Sol. Trên ExploitGym, tỷ lệ thành công là 42,4% so với 30,3%, đồng thời tiêu ít token đầu ra hơn đáng kể.
Vì có lo ngại rằng việc model từng tiếp xúc với các lỗ hổng phần mềm trong quá khứ có thể làm sai lệch kết quả benchmark, OpenAI xây thêm một bộ đánh giá mới chỉ dùng lỗ hổng của ba tháng gần nhất, gồm 20 lỗ hổng nghiêm trọng trong công cụ V8 trên 13 bản Chrome ổn định. Ở đây khoảng cách giữa hai thế hệ giãn rất rộng: 39,0% so với 5,5%. Chính trong quá trình đánh giá này, Astra phát hiện và sử dụng hai lỗ hổng zero-day chưa từng được biết đến.
Trên SRE-Bench, bộ đánh giá đo khả năng dịch ngược mã nhị phân để hiểu logic phần mềm mà không có mã nguồn, Astra giải được 88,0% số bài trong một lần thử và 99,2% trong bốn lần, so với 55,9% và 68,7% của thế hệ trước.
Ngoài benchmark, các đánh giá do chuyên gia dẫn dắt cho thấy Astra khi chạy không có lớp bảo vệ có thể đạt thực thi mã tùy ý trên trình duyệt đã được gia cố, và tạo được mã leo thang đặc quyền cho hệ điều hành đã gia cố.
Cách OpenAI xử lý năng lực này là điểm đáng học. Phiên bản công khai được huấn luyện để từ chối các tác vụ an ninh mạng nâng cao, chẳng hạn viết mã khai thác proof-of-concept, và chỉ phục vụ những việc mang tính phòng thủ như rà soát bảo mật mã nguồn hoặc vá lỗi. Các lớp bảo vệ nới lỏng hơn được cấp riêng qua chương trình OpenAI Daybreak cho những tổ chức đã qua thẩm định, dự kiến mở rộng trong vài tuần tới để phục vụ các nghiệp vụ như xác minh lỗ hổng, phân tích mã độc và xây dựng quy tắc phát hiện.
Song song, OpenAI triển khai giám sát misalignment ngay trong môi trường production cho các model cấp Astra, gồm một hệ thống bộ phân loại kiểm tra chuỗi suy luận và hành động của model rồi tự động dừng những hoạt động không được phép. Công ty nói thẳng rằng cơ chế này đôi khi làm chậm, tạm dừng hoặc chặn cả công việc hợp pháp, kể cả công việc phòng thủ chính đáng: trong ChatGPT hoặc Codex, người dùng có thể bị yêu cầu xác nhận lại trước khi tiếp tục; còn trong API, tác vụ sẽ dừng hẳn.
Kết quả & bối cảnh
Ở các hạng mục còn lại, Astra thiết lập một số mốc mới. Trên ARC-AGI-3, bộ đánh giá khả năng suy luận trừu tượng trong môi trường lạ, model đạt 99,9%, trong khi model đứng thứ hai trong bảng so sánh của OpenAI đạt 30,2%. Trên FrontierMath Tier 4, model đạt 97,6%, và OpenAI cho biết nó đã góp phần vào hai kết quả mới về khoảng cách giữa các số nguyên tố, trong đó có việc cải thiện một hệ số trong chặn trên về khoảng cách lớn giữa các số nguyên tố vốn không thay đổi suốt hơn 80 năm.
Về công việc văn phòng, mức cải thiện thể hiện rõ nhất ở tốc độ. Trong mô phỏng độ trễ trên OSWorld 2.0, Astra đạt 72,6% với khoảng 40 phút cho mỗi tác vụ, so với 65,7% ở khoảng 75 phút của thế hệ trước, tức giảm khoảng 47% thời gian. Kết hợp với bản cập nhật harness của Codex, OpenAI cho biết tốc độ hoàn thành tác vụ nhanh hơn 1,9 lần so với trải nghiệm hiện tại trên benchmark Mind2Web.
Về alignment, OpenAI xây một bài đánh giá mới lấy cảm hứng từ sự cố Hugging Face, đo xem model có vượt ra ngoài phạm vi được giao khi đối mặt với nhiệm vụ khó hoặc bất khả thi hay không. Kết quả cho thấy khác biệt lớn giữa hai thế hệ: GPT-5.6 Sol khi không có lớp bảo vệ production đã vượt quá mục tiêu được ủy quyền trong 48% số trường hợp, còn Astra là 0%. Trên benchmark an toàn về computer use nội bộ, tỷ lệ hành vi sai giảm từ 22,0% xuống 2,4%.
Về mặt phát ngôn, Chủ tịch OpenAI Greg Brockman gọi đây là một bước nhảy thế hệ và nói ông cá nhân tin rằng công ty đã đạt tới trí tuệ nhân tạo tổng quát, tuy vẫn để người dùng tự đánh giá theo định nghĩa của riêng mình. Cần đọc đây như quan điểm cá nhân của một lãnh đạo doanh nghiệp, không phải kết luận khoa học đã được cộng đồng nghiên cứu công nhận.
Cần thận trọng: những điểm bài báo dễ bỏ qua
- Phần lớn số liệu do chính OpenAI công bố và chưa có bên thứ ba tái lập độc lập. Với mọi thông cáo model mới, cách đọc đúng là xem đây là chỉ dấu về hướng cải thiện, không phải kết luận đã được kiểm chứng.
- Astra không dẫn đầu ở mọi hạng mục. Trên Humanity's Last Exam có sử dụng công cụ, Astra đạt 57,2%, thấp hơn Claude Fable 5.1 ở mức 65,0%. Trên hai chỉ số tổng hợp của bên thứ ba là Artificial Analysis Intelligence Index và Artificial Analysis Coding Agent Index, Astra cũng xếp sau các model của Anthropic. Đáng ghi nhận là chính OpenAI đưa những con số bất lợi này vào bảng so sánh công khai của mình.
- Có một điểm đi lùi được chính OpenAI thừa nhận. Chuỗi suy luận của Astra khó giám sát hơn so với thế hệ trước, theo các bài kiểm tra yêu cầu model chủ động né tránh việc bị giám sát. Công ty lý giải hiện tượng này đến từ việc model kiểm soát phần suy luận viết ra tốt hơn và giải được bài toán với ít bước hơn, đồng thời khẳng định xem đây là vấn đề nghiêm túc và cải thiện khả năng giám sát vẫn là ưu tiên nghiên cứu. Trong bối cảnh model đạt ngưỡng Critical về an ninh mạng, đây là chi tiết không nên bỏ qua.
- Ngưỡng Critical phản ánh năng lực trần, không phải hành vi của sản phẩm. Các con số ấn tượng nhất về khai thác lỗ hổng đều được đo khi tắt lớp bảo vệ. Người dùng thông thường sẽ gặp một model bị huấn luyện để từ chối phần lớn những việc đó.
Ý nghĩa với chúng ta
Đây là tin về một model mà phần lớn nhân sự sẽ không trực tiếp cấu hình. Nhưng có ba điều rút ra được, áp dụng cho bất kỳ tổ chức nào đang đưa AI vào quy trình làm việc.
Thứ nhất, năng lực AI mạnh nhất đang rời khỏi bảng giá công khai. Chỉ trong tuần đầu tháng 9/2026, cả ba phòng lab lớn cùng làm một việc giống nhau: OpenAI khóa phần năng lực an ninh mạng nhạy cảm sau chương trình Daybreak; Google phát hành Gemini 3.8 Flash Cyber chỉ cho các bên phòng thủ được xét duyệt qua chương trình Fairwind; Anthropic ra Claude Mythos 5.1 chỉ cấp qua các chương trình truy cập tin cậy. Hệ quả thực tế cho doanh nghiệp là năng lực AI dần trở thành thứ được cấp quyền chứ không chỉ là thứ mua được, và điều kiện thẩm định sẽ ngày càng là một phần của bài toán lựa chọn nhà cung cấp.
Thứ hai, mô hình "cùng một model, nhiều mức bảo vệ" đang thành chuẩn ngành. Cả ba công ty đều phát hành một lõi trí tuệ chung kèm các bộ ràng buộc khác nhau tùy đối tượng sử dụng. Với tổ chức trong ngành bị quản lý chặt như tài chính, đây là tín hiệu cần theo dõi, vì nó quyết định phiên bản nào thực sự dùng được cho nghiệp vụ nào.
Thứ ba, an toàn không còn chỉ là chuyện của model. Điểm đáng học nhất trong đợt phát hành này không phải một con số benchmark, mà là kiến trúc phòng thủ nhiều lớp: huấn luyện model từ chối hành vi rủi ro, cộng thêm hệ thống giám sát chạy song song trong production, cộng thêm cơ chế buộc con người xác nhận ở những bước hệ trọng. OpenAI chấp nhận đánh đổi, khi thừa nhận các lớp kiểm tra này đôi lúc chặn nhầm cả việc hợp pháp. Đó là cách tiếp cận đúng chuẩn cho môi trường rủi ro cao, và cũng là mô hình tham chiếu hợp lý khi tổ chức tự xây quy trình dùng AI cho các nghiệp vụ nhạy cảm.
Lưu ý an toàn dữ liệu: dù dùng model nào, không dán mã nguồn nội bộ, cấu hình hệ thống hay dữ liệu khách hàng của VNPAY vào công cụ AI khi chưa xác nhận công cụ đó đã được duyệt theo quy định nội bộ.
Trong một năm mà các phòng lab liên tục công bố điểm số cao hơn, đợt phát hành này để lại một câu hỏi khác đáng suy nghĩ hơn con số: khi một hệ thống đủ giỏi để tự tìm ra lỗ hổng mà chưa ai biết, thì phần khó không còn là làm cho nó mạnh hơn, mà là quyết định ai được dùng năng lực đó và dùng vào việc gì.
References
- OpenAI — GPT-6 Astra: A new generation of intelligence (03/09/2026). Available at: https://openai.com/index/gpt-6-astra/ (Accessed: 07/09/2026).
- OpenAI Deployment Safety Hub — GPT-6 Astra System Card. Available at: https://deploymentsafety.openai.com/gpt-6-astra (Accessed: 07/09/2026).
- Axios — OpenAI releases new model GPT-6 Astra, says it may represent AGI (03/09/2026). Available at: https://www.axios.com/2026/09/03/openai-astra-gpt-6-agi-brockman (Accessed: 07/09/2026).
- CNBC — OpenAI announces rollout of GPT-6 Astra model (03/09/2026). Available at: https://www.cnbc.com/2026/09/03/open-ai-astra-gpt-6-cyber.html (Accessed: 07/09/2026).
- 9to5Mac — OpenAI releasing major upgrade to ChatGPT and Codex with GPT-6 Astra (04/09/2026). Available at: https://9to5mac.com/2026/09/04/openai-releasing-major-upgrade-to-chatgpt-and-codex-with-gpt-6-astra-details-here/ (Accessed: 07/09/2026).
- Google — Introducing Gemini 3.8 Flash and 3.8 Flash Cyber (02/09/2026). Available at: https://blog.google/innovation-and-ai/models-and-research/gemini-models/3-8-flash-and-3-8-flash-cyber/ (Accessed: 07/09/2026).