
Khi một mô hình AI cần rẻ hơn, cách quen thuộc là giảm số tham số. Ít tham số hơn nghĩa là ít phép tính hơn, nhưng cũng nghĩa là biết ít hơn.
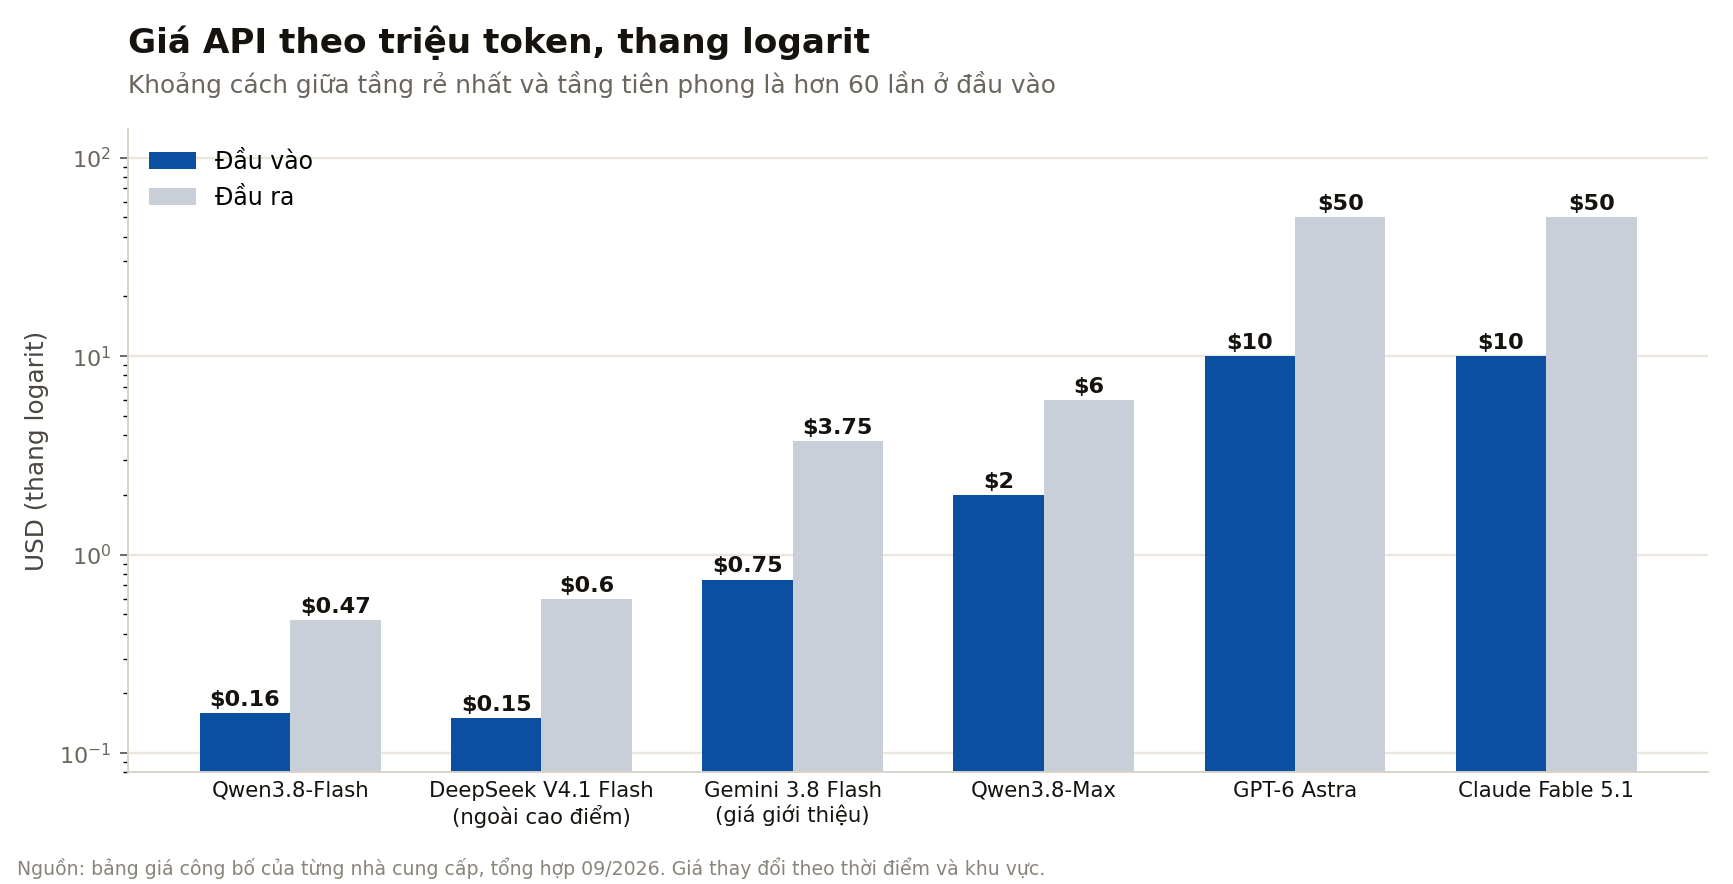
Ngày 26/8/2026, đội Qwen của Alibaba phát hành một mô hình tách đôi hai thứ vốn luôn đi cùng nhau: lượng tri thức mô hình lưu giữ và lượng phép tính nó phải thực hiện. Mô hình lưu khoảng 180 tỷ tham số trên đĩa, nhưng mỗi token chỉ kích hoạt 6 tỷ. Giá bán là 0,16 USD cho mỗi triệu token đầu vào, bằng khoảng một phần mười hai mô hình chủ lực Qwen3.8-Max của chính Alibaba.
Cách họ làm được điều đó là phần đáng đọc nhất.
Trước hết, làm rõ hai cái tên
Đây là chỗ nhiều bài đưa tin đã nhầm, nên cần tách bạch ngay:
- Qwen3.8-Flash là mã sản phẩm chạy trên dịch vụ QwenCloud. Đây là thứ bạn gọi qua API và trả tiền theo token.
- Qwen3.8-Flash-Next là bản trọng số mở trên Hugging Face và ModelScope. Đây là thứ bạn tải về tự triển khai.
Hai bản dùng chung kiến trúc nhưng không phải cùng một checkpoint. Bản API có thêm các tính năng chỉ có ở môi trường sản xuất, gồm ngữ cảnh 1 triệu token bật sẵn và bộ công cụ tích hợp.
Hậu tố "Next" là cách Qwen đánh dấu bản xem trước kiến trúc. Họ đã làm đúng như vậy một lần: mô hình Qwen3-Next tháng 9/2025 giới thiệu một thiết kế lai, và thiết kế đó sau này chạy xuyên suốt các dòng Qwen3.5, 3.6, 3.7 và 3.8. Lần này, các thành phần mới được phát hành sớm với ý định làm nền cho thế hệ Qwen4.
Chuyện gì đã xảy ra
Mô hình nằm trong một loạt ba bản phát hành chỉ trong bốn tuần, mỗi bản một vai trò rõ ràng:
| Mô hình | Ngày | Quy mô | Vai trò | Giá API |
|---|---|---|---|---|
| Qwen3.8-Max | 03/08/2026 | 2,4 nghìn tỷ, 95 tỷ kích hoạt | Mô hình chủ lực | 2,00 / 6,00 USD |
| Qwen3.8-27B | 14/08/2026 | 27 tỷ, dạng dày đặc | Chạy cục bộ, khoảng 17 GB VRAM | tự triển khai |
| Qwen3.8-Flash-Next | 26/08/2026 | 125 tỷ, 6 tỷ kích hoạt | Tầng chi phí thấp, xem trước Qwen4 | 0,16 / 0,47 USD |
Mô hình nhận văn bản, hình ảnh và video, trả về văn bản. Ngữ cảnh gốc là 262.144 token, mở rộng được lên 1 triệu.
Một điểm pháp lý cần đọc kỹ. Checkpoint này phát hành dưới giấy phép qwen-community-1.0, không phải Apache 2.0, dù kho GitHub mẹ có ghi Apache trong tệp giấy phép. Các phiên bản trước của giấy phép Qwen Community từng có ràng buộc thương mại với đơn vị vượt ngưỡng 100 triệu người dùng hoạt động hằng tháng. Trước khi dùng cho mục đích thương mại, cần đọc nguyên văn điều khoản.
Điểm cốt lõi: một bảng tra cứu không tốn phép tính nào
Mô hình gồm ba khối tham số, và chỉ một khối thực sự tham gia tính toán.
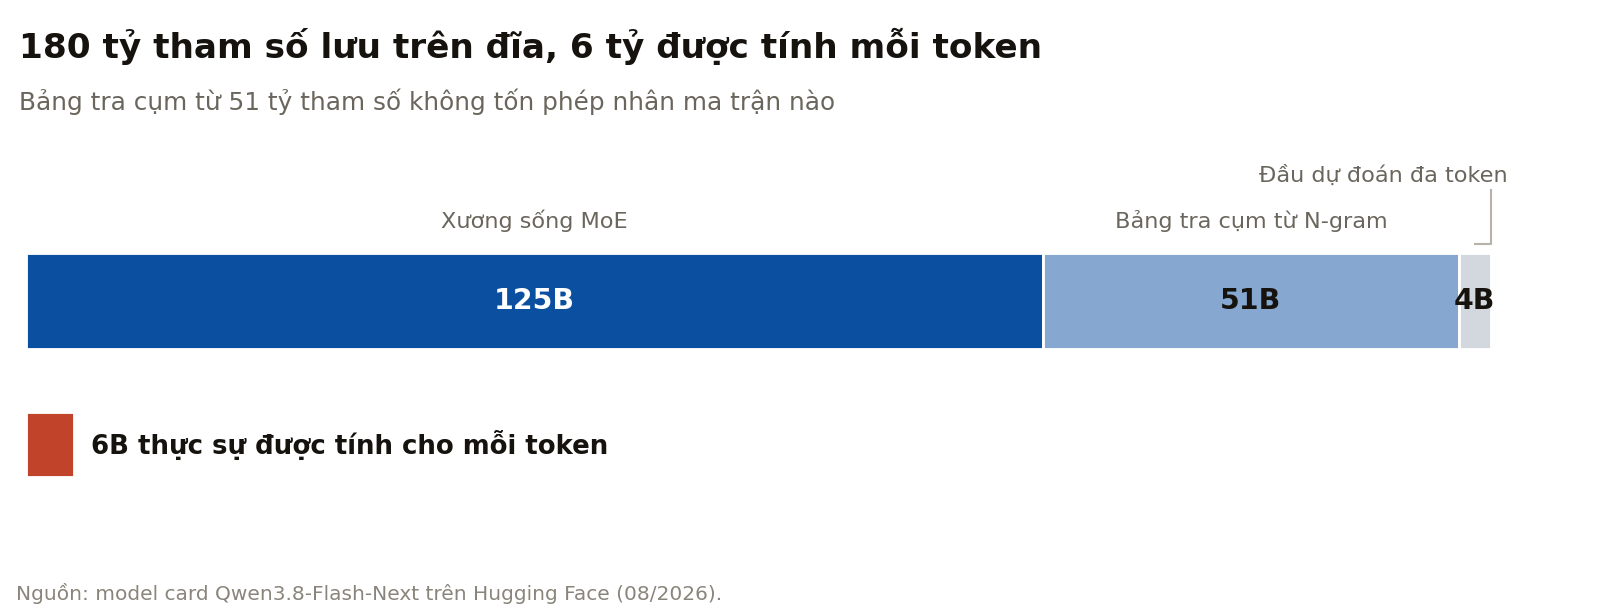
Khối thứ nhất là xương sống dạng MoE với 125 tỷ tham số, trong đó chỉ khoảng 6 tỷ được kích hoạt cho mỗi token, tương đương chưa tới 5%. Mỗi lớp có 512 chuyên gia, mỗi token được định tuyến tới 10 chuyên gia cộng một chuyên gia dùng chung.
Khối thứ hai là điểm thú vị nhất. Đó là một bảng tra cụm từ 51 tỷ tham số, chứa 20 triệu mục cho các cặp và bộ ba từ liên tiếp, đặt ngay ở lớp thứ hai của mạng. Khác với tham số thông thường, bảng này không tham gia phép nhân ma trận nào. Vị trí cần tra được xác định hoàn toàn từ chuỗi token đang xử lý, nên nó chỉ là một phép tra cứu thuần tuý. Vì địa chỉ tra biết trước, bảng có thể nằm trong RAM hệ thống thay vì bộ nhớ GPU, và được nạp trước song song với quá trình tính toán chính.
Nói cách khác: đây là một cuốn sổ tay khổng lồ về các cụm từ thông dụng, để phần xương sống 6 tỷ tham số được rảnh tay lo những việc thật sự cần suy luận. Đây là một trục mở rộng tham số rẻ hơn hẳn việc thêm chuyên gia MoE, vì nó không tốn thêm một phép tính nào trên GPU.
Khối thứ ba là một đầu dự đoán đa token 4 tỷ tham số, chỉ dùng khi bật chế độ giải mã suy đoán.
Hai loại lớp chia việc cho nhau
Bốn mươi tám lớp của mô hình được xếp thành mười hai cụm, mỗi cụm gồm ba lớp chú ý tuyến tính và một lớp chú ý thưa. Tỷ lệ là ba trên một.
Lớp chú ý tuyến tính nén toàn bộ lịch sử chuỗi vào một trạng thái có kích thước cố định, nên chi phí không tăng theo độ dài văn bản. Lớp chú ý thưa thì làm việc khác: nó gộp chuỗi thành các khối nhỏ, ước lượng mức quan trọng ở cấp khối chứ không phải từng token, rồi chỉ chú ý đầy đủ vào những khối đáng quan tâm nhất, với hạn mức cố định 512 khối mỗi lớp.
Alibaba mô tả cách chia việc này rất gọn: loại lớp thứ nhất lo ghi nhớ hiệu quả, loại lớp thứ hai lo truy hồi chính xác.
Hệ quả về tốc độ, theo số liệu Alibaba công bố ở mức ngữ cảnh 1 triệu token: nhân chú ý thưa nhanh gấp tới 7,6 lần khi nạp đầu vào và 4,9 lần khi sinh đầu ra, so với chú ý đầy đủ. Trong kịch bản phục vụ trực tuyến có tỷ lệ trúng bộ đệm 90%, thông lượng nạp đầu vào gấp 8,6 lần thế hệ trước.
Phía huấn luyện
Alibaba dùng một bộ tối ưu hoá mới cho các ma trận trọng số, giữ bộ tối ưu hoá cũ cho phần nhúng và bộ định tuyến. Họ cũng hiệu chỉnh lại quy luật tỷ lệ cho kiến trúc mới, và bỏ hẳn bước khởi động dần kích thước lô, một thực hành tiêu chuẩn trong huấn luyện mô hình lớn. Phát hiện của họ đi ngược thông lệ: tăng dần kích thước lô không cải thiện kết quả cuối, mà còn tốn thêm 18,8% số bước tối ưu hoá.
Tổng lại, chi phí huấn luyện được báo cáo bằng khoảng một phần chín so với mô hình cùng tầm thế hệ trước.
Kết quả & bối cảnh
Bộ benchmark Alibaba chọn công bố nghiêng hẳn về công việc agent và công việc văn phòng. Các bài kiểm tra kiến thức tổng quát mà mô hình tiền nhiệm từng báo cáo thì lần này không có. Bản thân việc chọn lọc đó cũng là một dữ kiện: đây được định vị là mô hình agent, không phải mô hình tri thức.
Theo số liệu tự công bố:
| Bộ đánh giá | Flash-Next | Claude Opus 4.6 | DeepSeek V4-Flash |
|---|---|---|---|
| SWE-bench Pro | 62,5 | 53,4 | 56,0 |
| SWE-bench đa ngôn ngữ | 81,0 | 77,5 | — |
| DeepSWE 1.1 | 58,7 | — | 54,4 |
| CoWorkBench | 73,9 | 68,2 | 45,1 |
| JobBench | 55,7 | 36,6 | 41,3 |
| LiveCodeBench v6 | 91,9 | 88,8 | 90,6 |
| NL2Repo-Bench | 48,1 | 47,6 | 54,2 |
| HLE | 35,9 | 40,0 | 33,8 |
Về giá, khoảng cách giữa các tầng rất lớn:
Một chi tiết thực dụng: dịch vụ của Alibaba cung cấp cả giao diện tương thích OpenAI lẫn giao diện tương thích Anthropic. Nghĩa là đội ngũ đang dùng Claude Code có thể chuyển sang mô hình này chỉ bằng cách đổi vài biến môi trường, không phải viết lại mã. Tiện lợi đó đi kèm một câu hỏi về dữ liệu mà phần dưới sẽ nói tới.
Cần thận trọng: năm điểm dễ bị bỏ qua
Bảng so sánh dùng một mô hình đã cũ làm mốc. Đây là điểm quan trọng nhất. Claude Opus 4.6 ra mắt từ tháng 2/2026, tức là đã hai thế hệ. Đặt cạnh các mô hình hiện tại thì khoảng cách rộng hẳn ra: trên SWE-bench Pro, con số 62,5 đứng trước 80,3 của thế hệ Opus 5; trên DeepSWE, 58,7 đứng trước 72,7 của GPT-5.6 Sol. Mô hình này mạnh trong tầng giá của nó, không phải mạnh so với tuyến đầu.
Toàn bộ số liệu do Alibaba tự công bố, và tại thời điểm phát hành gần như chưa có kiểm chứng độc lập. Một bảng xếp hạng bên thứ ba xếp mô hình ở hạng 25 trên 226 về tổng thể, và hạng 13 trên 138 ở nhóm agent, nhưng nhiều nhóm khác chưa đủ dữ liệu để xếp.
Có một hạng mục mô hình thua rõ. Trên bài kiểm tra sinh mã ở quy mô toàn kho, mô hình đạt 48,1 điểm, kém DeepSeek V4-Flash ở mức 54,2. Nếu công việc chính là sinh mã cho cả một kho nguồn thay vì làm việc theo kiểu agent nhiều bước, đây là con số cần cân nhắc.
Không phải một tác nhân điều khiển máy tính. Trên bài đánh giá điều khiển máy tính, tỷ lệ hoàn thành trọn vẹn nhiệm vụ chỉ đạt 19,4%. Mô hình tiến được một phần chặng đường ở phần lớn nhiệm vụ nhưng hiếm khi làm xong hoàn chỉnh.
Vài chi tiết kỹ thuật gây bất ngờ khi triển khai. Cơ chế mở rộng ngữ cảnh lên 1 triệu token là loại tĩnh, nên hệ số giãn giữ nguyên bất kể độ dài đầu vào và có thể làm giảm chất lượng với câu lệnh ngắn; tài liệu khuyên chọn hệ số nhỏ hơn nếu ngữ cảnh thực tế không quá dài. Chế độ suy luận mặc định ở mức cao nhất khiến mô hình trả lời dài dòng. Và việc chuyển bảng tra cụm từ sang RAM hệ thống hiện chỉ hỗ trợ phần cứng NVIDIA.
Về tự triển khai: bản đầy đủ cần khoảng 335 GiB, bản FP8 khoảng 173 GiB, còn bản lượng tử hoá 4 bit khoảng 82 GB nên chạy được trên máy có bộ nhớ hợp nhất cỡ 128 GB. Đây là mô hình thuộc nhóm hiếm hoi ở tầm năng lực này mà máy trạm cao cấp còn chạy nổi.
Ý nghĩa với chúng ta
Đây là tin về một mô hình mà phần lớn nhân sự sẽ không dùng trực tiếp. Nhưng có bốn điều rút ra được.
Thứ nhất, đây là bằng chứng thứ hai cho cùng một xu hướng. Bản phát hành này và DeepSeek V4.1 Flash cách nhau đúng hai tuần, đến từ hai phòng lab khác nhau, nhưng cùng trả lời một câu hỏi theo cùng một hướng: hạ chi phí bằng cách thiết kế lại kiến trúc, không phải bằng cách thu nhỏ mô hình. Một bên nén bộ đệm khi đọc, một bên tách phần tri thức ra khỏi phần tính toán. Với đội ngũ theo dõi chi phí AI, đây là xu hướng đáng ghi nhận hơn bất kỳ điểm benchmark nào.
Thứ hai, kiểm tra giấy phép trước khi làm gì khác. Việc checkpoint dùng giấy phép riêng chứ không phải Apache 2.0 là chi tiết dễ bỏ sót, nhất là khi kho GitHub mẹ lại ghi Apache. Với một doanh nghiệp trong ngành tài chính, đây là việc của pháp chế chứ không phải của người thử nghiệm.
Thứ ba, sự tiện lợi của giao diện tương thích là con dao hai lưỡi. Việc chuyển từ Claude Code sang mô hình này chỉ tốn vài biến môi trường nghe rất hấp dẫn, nhưng điều đó cũng nghĩa là một thay đổi nhỏ trong cấu hình đủ để chuyển hướng toàn bộ dữ liệu sang máy chủ của một nhà cung cấp khác, ở một khu vực pháp lý khác. Đây là loại rủi ro nên được nêu rõ trong quy định nội bộ về dùng công cụ AI, thay vì để từng người tự quyết.
Thứ tư, chọn mô hình theo loại việc, không theo thứ hạng chung. Bảng điểm cho thấy cùng một mô hình dẫn đầu ở công việc agent nhiều bước nhưng thua ở sinh mã quy mô kho, và kém rõ ở suy luận khó. Kết luận này lặp lại điều mà bài về benchmark Real-SWE đã nêu: cách đáng tin nhất vẫn là tự đo trên khối lượng công việc thật của mình.
Lưu ý an toàn dữ liệu: với mô hình do đơn vị nước ngoài phát triển, cần phân biệt rõ hai hình thức. Gọi qua API của nhà cung cấp là gửi dữ liệu ra ngoài, tới máy chủ đặt tại Bắc Kinh, Singapore hoặc Hoa Kỳ tuỳ điểm truy cập. Tự triển khai trọng số trên hạ tầng của mình thì không. Hai hình thức có mức rủi ro hoàn toàn khác nhau và cần được xem xét riêng. Nguyên tắc chung không đổi: không đưa mã nguồn nội bộ, cấu hình hệ thống hay dữ liệu khách hàng vào công cụ AI chưa được duyệt.
Trong một năm mà phần lớn thông cáo về mô hình mới xoay quanh việc điểm số nhích lên bao nhiêu, bản phát hành này nhắc lại một điều cơ bản của nghề kỹ thuật: khi một ràng buộc trở nên quá đắt, cách giải quyết thường không phải chấp nhận ít hơn, mà là tìm ra rằng ràng buộc đó vốn không cần thiết như ta tưởng.
References
- Qwen (Alibaba) — Qwen3.8-Flash-Next (model card và báo cáo kỹ thuật). Available at: https://huggingface.co/Qwen/Qwen3.8-Flash-Next (Accessed: 16/09/2026).
- Alibaba Cloud — Qwen3.8-Flash-Next: a new architecture towards ultimate cost efficiency (26/08/2026). Available at: https://www.alibabacloud.com/blog/qwen3-8-flash-next-a-new-architecture-towards-ultimate-cost-efficiency_603501 (Accessed: 16/09/2026).
- QwenLM — Qwen3.8-Flash-Next (kho mã nguồn). Available at: https://github.com/QwenLM/Qwen3.8-Flash-Next (Accessed: 16/09/2026).
- The Decoder — Alibaba releases Qwen3.8-Flash-Next, targeting "ultimate cost efficiency" (08/2026). Available at: https://the-decoder.com/alibaba-releases-qwen3-8-flash-next-targeting-ultimate-cost-efficiency/ (Accessed: 16/09/2026).
- MarkTechPost — Alibaba's Qwen Team Releases Qwen3.8-Flash-Next: A 125B Multimodal MoE With 6B Active Parameters (26/08/2026). Available at: https://www.marktechpost.com/2026/08/26/alibabas-qwen-team-releases-qwen3-8-flash-next-a-125b-multimodal-moe-with-6b-active-parameters-previewing-the-qwen4-architecture/ (Accessed: 16/09/2026).
- TechNode — Alibaba's Qwen to open-source Qwen3.8-Flash-Next, previewing Qwen4 architecture (26/08/2026). Available at: https://technode.com/2026/08/26/alibabas-qwen-to-open-source-qwen3-8-flash-next-previewing-qwen4-architecture/ (Accessed: 16/09/2026).
- Local AI Zone — Qwen3.8-Flash-Next: A Deep-Dive into Alibaba Qwen4 Architecture Preview (27/08/2026), phân tích kỹ thuật độc lập. Available at: https://local-ai-zone.github.io/blog/qwen3-8-flash-next-deep-dive.html (Accessed: 16/09/2026).