
Trên các bộ đánh giá quen thuộc, những mô hình hàng đầu hiện giải được khoảng 70 đến 80% số bài. Con số đó tạo ấn tượng rằng phần lớn công việc kỹ thuật phần mềm đã nằm trong tầm với của AI. Tháng 9/2026, một bộ đánh giá mới đặt câu hỏi khác: nếu thay kho mã nguồn mở bằng codebase thật của một doanh nghiệp mà mô hình chưa từng thấy, kết quả sẽ ra sao.
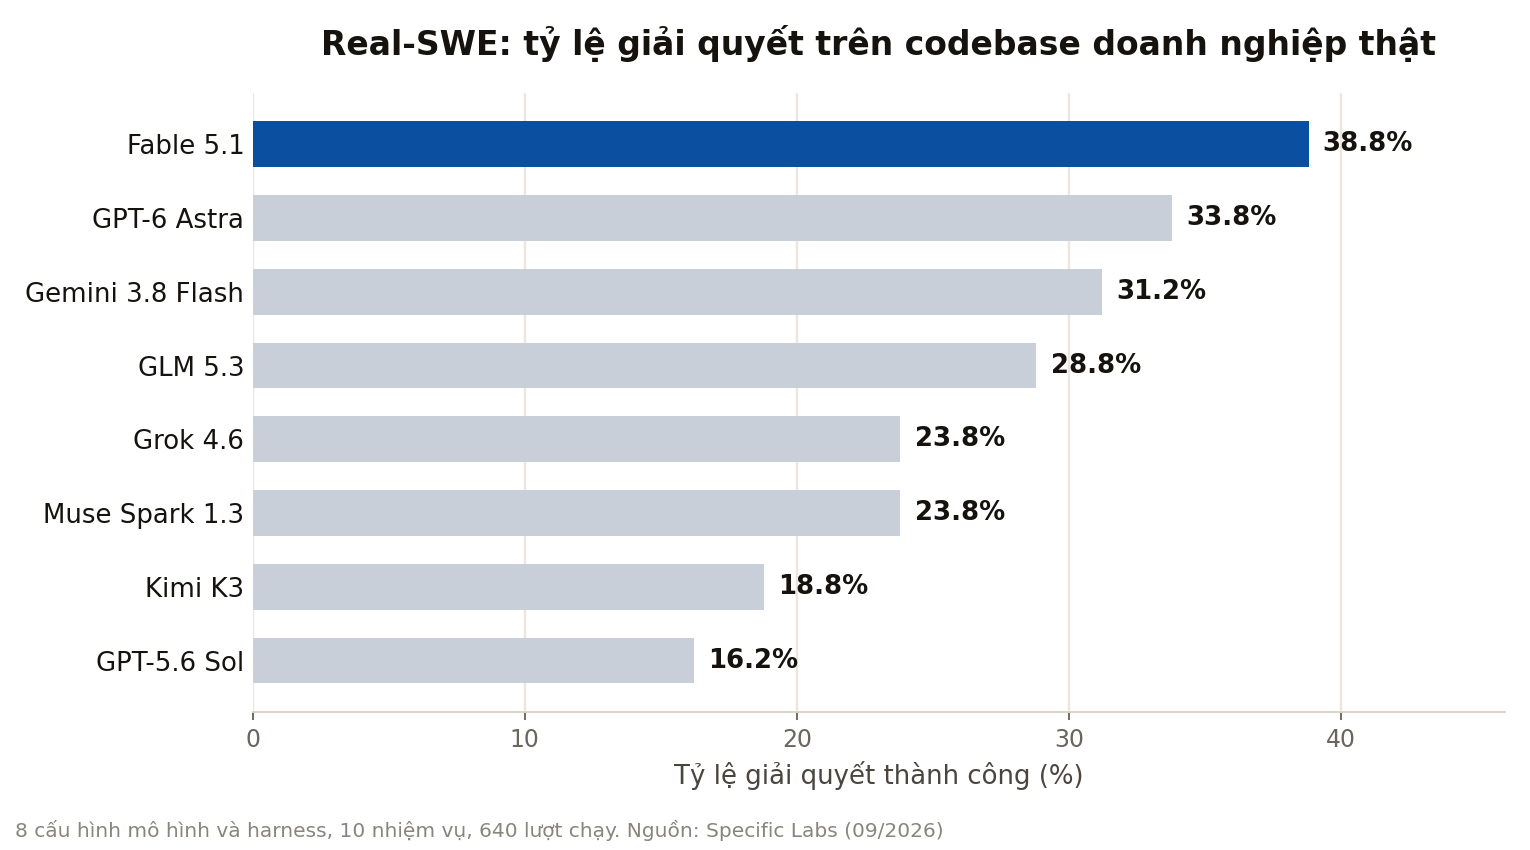
Câu trả lời là 38,8% cho mô hình dẫn đầu. Nhưng con số không phải phần đáng chú ý nhất. Phần đáng chú ý nằm ở nguyên nhân thất bại: các mô hình phần lớn không thua vì viết sai mã, mà vì bỏ sót yêu cầu và hành động dựa trên giả định chưa được kiểm chứng.
Chuyện gì đã xảy ra
Specific Labs, một công ty thuộc khoá F25 của Y Combinator, công bố Real-SWE trong tháng 9/2026. Điểm khác biệt căn bản so với các bộ đánh giá hiện có nằm ở nguồn dữ liệu: mỗi nhiệm vụ được lấy từ một codebase sản xuất tư nhân mà công ty này mua hoặc cấp phép từ doanh nghiệp thật, kèm nguyên vẹn bối cảnh và độ phức tạp của một sản phẩm đang vận hành.
Lập luận của nhóm tác giả có ba phần. Thứ nhất, nhiệm vụ trên codebase tư nhân nằm ngoài phân phối dữ liệu huấn luyện một cách tự nhiên, vì chúng không tồn tại ở bất cứ đâu trên internet công khai. Nhóm ước tính khoảng 99% lượng token bên trong doanh nghiệp thực tế nằm ngoài tầm với của các mô hình tiên phong. Thứ hai, đây là công việc có giá trị kinh tế thật, mỗi nhiệm vụ đều từng được giao cho một kỹ sư hưởng lương. Thứ ba, nó kiểm tra được điều mà benchmark công khai khó chạm tới: mô hình có hiểu và tuân theo quy ước viết mã riêng của từng công ty hay không.
Về quy mô, bản công bố gồm 8 cấu hình mô hình kết hợp harness, 10 nhiệm vụ, và 640 lượt chạy được chấm điểm. Mỗi nhiệm vụ chạy 8 lượt độc lập cho mỗi mô hình, tỷ lệ giải quyết tương đương pass@1 lấy trung bình trên 8 lượt đó.
Các codebase được chọn qua sàng lọc, gồm một ứng dụng sự kiện có hơn 200 nghìn người dùng từng lọt top 100 App Store, một nền tảng fintech tiêu dùng xử lý hơn 100 nghìn sao kê ngân hàng, và các nền tảng bán hàng doanh nghiệp. Môi trường nhiệm vụ trải rộng qua Docker, Kubernetes, PostgreSQL, MySQL, MongoDB, Redis, Go, Python, Node.js, cùng các công cụ nghiệp vụ như Slack, Intercom, Google Drive, Linear và ClickUp.
Điểm cốt lõi: lỗi nằm ở khâu hiểu yêu cầu, không nằm ở khâu viết mã
Đây là phát hiện đáng học nhất, và cũng là lý do bài này đáng đọc với người làm phân tích nghiệp vụ và quản trị dự án chứ không riêng lập trình viên.
Nhóm tác giả phân loại mọi lượt chạy thất bại theo năm kiểu, dùng cùng một khung phân loại cho tất cả mô hình:
| Kiểu lỗi | Mô tả |
|---|---|
| Bỏ sót yêu cầu | Thiếu một hành vi mà chỉ dẫn có nêu |
| Lỗi tích hợp | Ý tưởng đúng nhưng nối vào hệ thống xung quanh sai |
| Giả định chưa kiểm chứng | Hành động dựa trên phỏng đoán về hệ thống thay vì kiểm tra lại trong mã |
| Phá vỡ hành vi cũ | Làm hỏng chức năng đang chạy khi thực hiện thay đổi |
| Sửa nhầm file | Đặt thay đổi vào nơi ứng dụng đang chạy không bao giờ gọi tới |
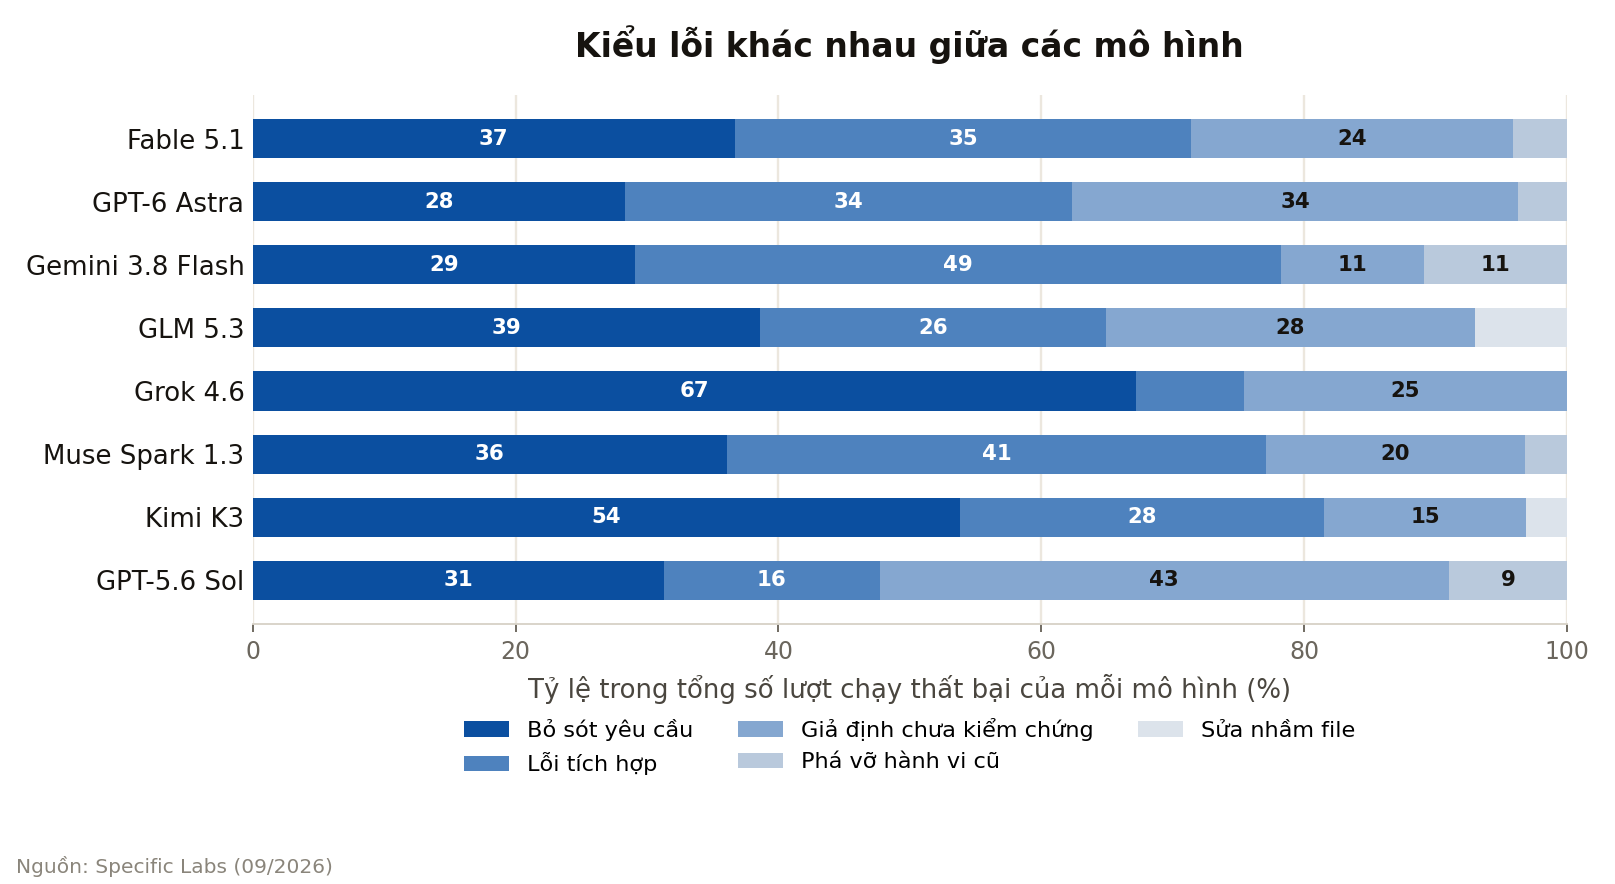
Xét trên toàn bộ, bỏ sót yêu cầu là kiểu lỗi phổ biến nhất. Nhưng bức tranh chi tiết cho thấy mỗi mô hình hỏng theo một cách riêng, và khác biệt khá lớn:
- Grok 4.6 bỏ sót yêu cầu ở 67,2% số lượt thất bại, cao nhất trong nhóm. Kimi K3 đứng thứ hai với 53,8%.
- Gemini 3.8 Flash lại có lỗi hàng đầu là lỗi tích hợp với 49,1%, trong khi tỷ lệ bỏ sót yêu cầu chỉ 29,1%.
- GPT-5.6 Sol có lỗi hàng đầu là giả định chưa kiểm chứng với 43,3%.
- Fable 5.1, mô hình dẫn đầu bảng, phân bố khá đều giữa ba kiểu lỗi chính.
Ba kiểu lỗi chiếm ưu thế tuyệt đối là bỏ sót yêu cầu, lỗi tích hợp và giả định chưa kiểm chứng. Cả ba đều thuộc nhóm hiểu sai bối cảnh, không thuộc nhóm viết sai cú pháp hay sai thuật toán. Kiểu lỗi phá vỡ hành vi cũ và sửa nhầm file gần như không đáng kể, cao nhất cũng chỉ khoảng một phần mười.
Một số liệu bổ trợ củng cố kết luận này: 71,4% số lượt chạy dưới mười phút thất bại, so với 73,4% ở các lượt dài hơn. Chênh lệch gần như không đáng kể, nghĩa là để mô hình chạy lâu hơn không giúp nó làm đúng. Vấn đề không nằm ở thời lượng suy nghĩ mà ở việc nắm bắt yêu cầu ngay từ đầu.
Kết quả & bối cảnh
| Hạng | Mô hình | Harness | Tỷ lệ giải quyết | Chi phí mỗi lượt |
|---|---|---|---|---|
| 1 | Claude Fable 5.1 | Claude Code | 38,8% | 6,96 USD |
| 2 | GPT-6 Astra | Codex CLI | 33,8% | 4,67 USD |
| 3 | Gemini 3.8 Flash | Gemini CLI | 31,2% | 2,50 USD |
| 4 | GLM 5.3 | Claude Code | 28,8% | 5,12 USD |
| 5 | Grok 4.6 | Grok Build | 23,8% | 3,44 USD |
| 5 | Muse Spark 1.3 | Muse Code | 23,8% | 2,74 USD |
| 7 | Kimi K3 | Kimi Code | 18,8% | 3,90 USD |
| 8 | GPT-5.6 Sol | Codex CLI | 16,2% | 2,65 USD |
Để có mốc so sánh, trên các bộ đánh giá công khai phổ biến hiện nay, mô hình tiên phong thường đạt từ 54 đến 81%. Khoảng cách giữa hai nhóm con số là điều bộ đánh giá này muốn làm nổi bật.
Về chi phí, quan hệ với hiệu quả không hề tuyến tính.
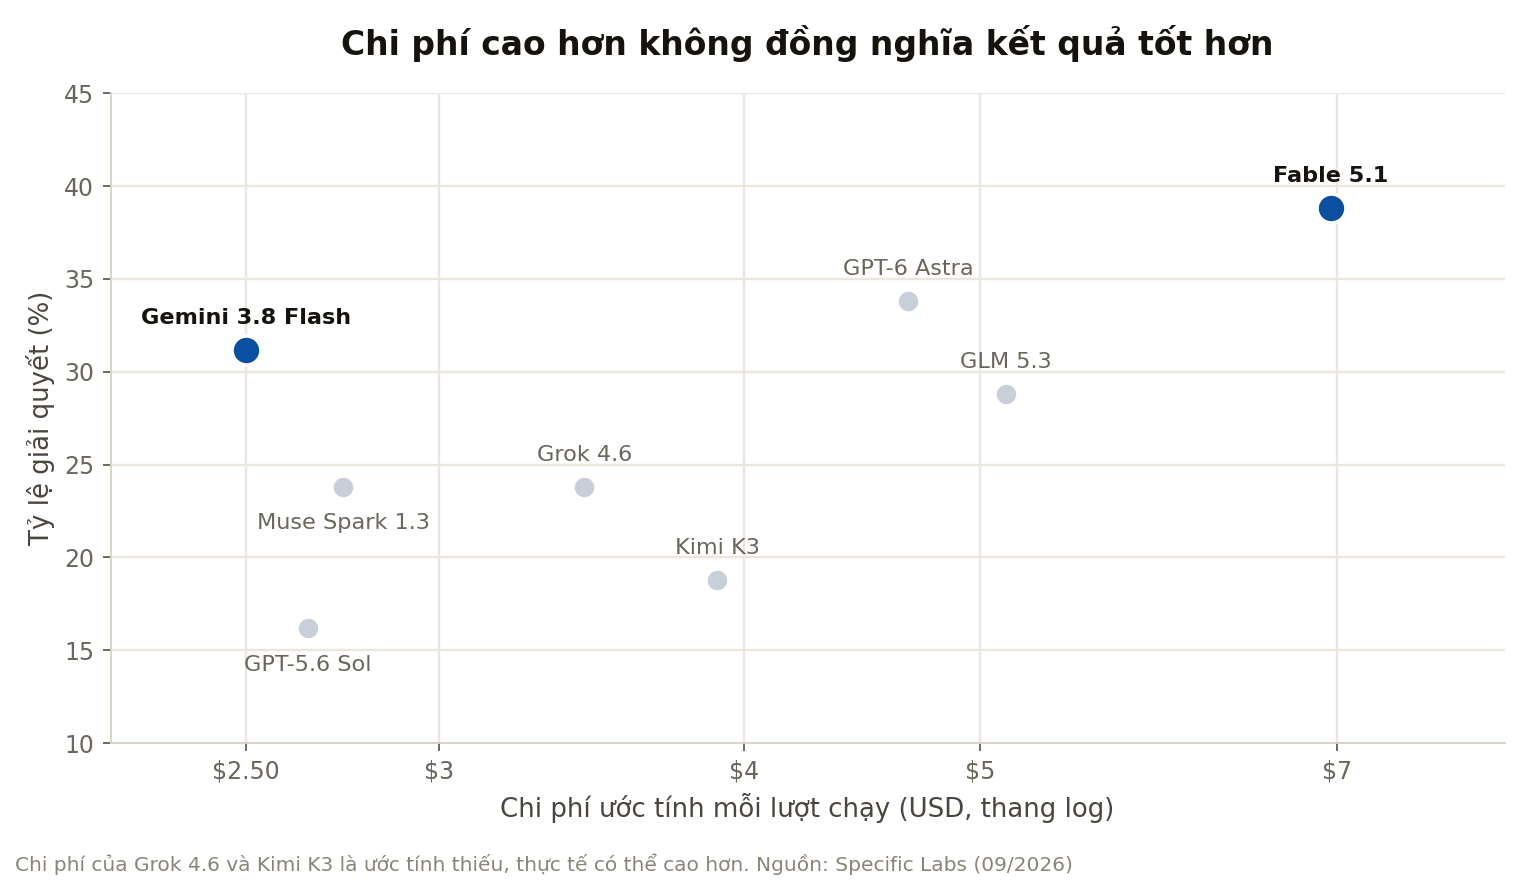
Gemini 3.8 Flash đạt 31,2% với chi phí 2,50 USD mỗi lượt, tức khoảng 36% chi phí của Fable 5.1 nhưng vẫn giữ được khoảng 80% hiệu quả. Ở chiều ngược lại, GLM 5.3 tốn 5,12 USD nhưng chỉ đạt 28,8%, thấp hơn Gemini 3.8 Flash vốn rẻ hơn một nửa. Còn GPT-5.6 Sol tuy rẻ nhưng xếp cuối bảng.
Về độ khó của từng nhiệm vụ, phân hoá rất mạnh. Sáu trên mười nhiệm vụ có tỷ lệ giải quyết dưới 15%.
| Nhiệm vụ | Tỷ lệ giải quyết chung |
|---|---|
| Quét đa vùng | 67,2% |
| Khoá API và môi trường | 65,6% |
| Dòng vượt hạn mức | 50,0% |
| Di trú định danh khách hàng | 40,6% |
| Di trú lịch thanh toán định kỳ | 14,1% |
| Đo lường token API | 12,5% |
| Đo lường kho dữ liệu S3 | 10,9% |
| Quét tuyến tính hoá | 4,7% |
| Thẩm quyền thuế | 3,1% |
| Bộ rút gọn luồng phân tích | 0,0% |
Nhiệm vụ cuối cùng là điểm đáng chú ý: không mô hình nào giải được dù chỉ một lần trong 64 lượt chạy.
Một điểm khác cần lưu ý khi đọc bảng này: các nhiệm vụ khó nhất tập trung vào thanh toán, thuế và đo lường sử dụng, tức đúng nhóm nghiệp vụ đặc thù của ngành tài chính. Nhiệm vụ mẫu được công bố công khai là một ví dụ điển hình: sửa phần lập hoá đơn sao cho mỗi doanh nghiệp trên nền tảng tính đúng thuế theo cấu hình riêng, khách hàng được miễn trừ không bị tính thuế, địa chỉ bị nhà cung cấp thuế từ chối phải được báo lại mà không làm dừng hoá đơn, và sau khi hoá đơn tất toán thì giao dịch phải được nộp ngược về cơ quan thuế theo đúng số hoá đơn để đối soát khớp. Nhiệm vụ này đạt 3,1%.
Về độ phức tạp, bản giải chuẩn của Real-SWE sửa trung vị 11 file, so với 6 file ở hai bộ đánh giá đối chiếu là FrontierCode và DeepSWE. Trong khi đó, độ dài chỉ dẫn lại tương đương, trung vị 1.742 ký tự so với 2.056 và 1.975 ký tự. Nói cách khác, cùng một lượng mô tả nhưng phải thay đổi gấp đôi số file.
Cần thận trọng: bốn giới hạn khi đọc kết quả này
- Đơn vị công bố có lợi ích thương mại. Specific Labs kinh doanh chính là xây dựng và cấp phép môi trường cùng dữ liệu doanh nghiệp cho việc huấn luyện và đánh giá AI. Một kết quả cho thấy benchmark công khai không phản ánh đúng thực tế phục vụ trực tiếp mô hình kinh doanh đó. Điều này không làm số liệu sai, nhưng là bối cảnh cần biết khi đọc.
- Quy mô mẫu nhỏ. Mười nhiệm vụ và 640 lượt chạy là ít cho một bảng xếp hạng tám mô hình. Với 8 lượt cho mỗi cặp mô hình và nhiệm vụ, khoảng tin cậy sẽ rộng, và khác biệt vài điểm phần trăm giữa các mô hình kề nhau có thể không có ý nghĩa thống kê.
- Kết quả từng nhiệm vụ biến động rất mạnh. Ở nhiệm vụ di trú định danh khách hàng, Grok 4.6 vốn xếp hạng 5 lại đạt 8 trên 8 lượt, trong khi GPT-6 Astra xếp hạng 2 chỉ đạt 1 trên 8. Mức dao động này cho thấy thứ hạng tổng thể chưa nói được nhiều về năng lực trên một loại việc cụ thể.
- Benchmark đo cặp mô hình cộng harness, không đo mô hình đơn lẻ. Nhóm tác giả nói rõ họ dùng harness gốc của từng hãng để phản ánh cách kỹ sư doanh nghiệp làm việc thực tế. Hệ quả là kết quả trộn lẫn năng lực mô hình với chất lượng công cụ bao quanh nó. Đáng chú ý, GLM 5.3 được chạy trên Claude Code chứ không phải harness riêng. Ngoài ra, chi phí của Grok 4.6 và Kimi K3 được ghi chú là ước tính thiếu, thực tế có thể cao hơn.
Ý nghĩa với chúng ta
Đây là tin về một bộ đánh giá kỹ thuật, nhưng kết luận của nó lại thuộc về địa hạt phân tích nghiệp vụ. Ba điểm áp dụng được ngay.
Thứ nhất, chất lượng tài liệu đặc tả là biến số quyết định, không phải chọn mô hình nào. Khi ba kiểu lỗi hàng đầu đều là bỏ sót yêu cầu, hiểu sai bối cảnh tích hợp và hành động trên giả định chưa kiểm chứng, thì đầu tư vào việc mô tả yêu cầu đầy đủ và rõ ràng có tác động lớn hơn việc đổi sang mô hình đắt hơn. Kết quả rằng chạy lâu hơn không cải thiện tỷ lệ thành công càng củng cố điều này: không thể bù đắp một yêu cầu mơ hồ bằng cách cho AI thêm thời gian.
Thứ hai, nên yêu cầu AI kiểm chứng giả định thay vì phỏng đoán. Kiểu lỗi "giả định chưa kiểm chứng" chiếm từ 10,9% đến 43,3% số lượt thất bại tuỳ mô hình. Đây là thứ có thể giảm bằng cách viết yêu cầu rõ hơn: buộc AI nêu ra các giả định nó đang dựa vào, và kiểm tra lại trong mã nguồn hoặc tài liệu trước khi thực hiện. Nguyên tắc này trùng với cách tiếp cận mà AI Hub đã nhiều lần nhấn mạnh ở các bài về prompt và về skill.
Thứ ba, chi phí không đi cùng chất lượng theo tỷ lệ thuận. Với đội ngũ đang dự toán chi phí AI, dữ liệu này cho thấy nên đo trên khối lượng công việc thật của mình thay vì chọn theo bảng xếp hạng chung. Một mô hình rẻ hơn ba lần vẫn có thể giữ được phần lớn hiệu quả tuỳ loại việc.
Lưu ý an toàn dữ liệu: không đưa mã nguồn nội bộ, cấu hình hệ thống hay dữ liệu khách hàng của VNPAY vào công cụ AI khi chưa xác nhận công cụ đó đã được duyệt theo quy định nội bộ.
Trong một năm mà các bảng điểm liên tục lập kỷ lục mới, bộ đánh giá này nhắc lại một điều cơ bản mà ngành phần mềm vốn đã biết từ lâu: phần khó nhất của việc xây phần mềm chưa bao giờ là viết mã, mà là hiểu cho đúng thứ cần xây.
References
- Specific Labs — Introducing Real-SWE: Benchmarking frontier AI models on private, real-world, enterprise codebases (09/2026), tác giả Snagnik Das, Siddhant Paliwal, Janak Sunil. Available at: https://realswe.withspecific.com (Accessed: 14/09/2026).
- Y Combinator — Specific Labs: Real World Environments and Data for AI. Available at: https://www.ycombinator.com/companies/specific-labs (Accessed: 14/09/2026).
- Hacker News — Real-SWE: Benchmarking AI models on private, real-world, enterprise codebases, thảo luận cộng đồng. Available at: https://news.ycombinator.com/item?id=49676820 (Accessed: 14/09/2026).
- Scale AI — SWE-Bench Pro Leaderboard, dùng làm mốc đối chiếu về benchmark trên codebase tư nhân. Available at: https://labs.scale.com/leaderboard/swe_bench_pro_public (Accessed: 14/09/2026).